שני המודלים החדשים מציעים חלון הקשר של מיליון טוקנים, זיכרון מתמשך ויכולת להמשיך במשימות מורכבות גם אחרי שגיאות
לפני קצת יותר משנה, מארק צוקרברג החליט שצריך לשנות כיוון. מודלי הבינה המלאכותית של מטא התקשו לעמוד בקצב של OpenAI, Anthropic וגוגל, והשקעות העתק של החברה עדיין לא תורגמו להובלה טכנולוגית. התגובה הייתה השקעה של 14.3 מיליארד דולר ב-Scale AI, גיוס אגרסיבי של חוקרים ובנייה מחדש של חטיבת ה-AI. עכשיו מגיע מבחן התוצאה: מטא השיקה את Muse Wonder ו-Muse Wonder Full, שני מודלים שמצליחים להתחרות ישירות במערכות המתקדמות בשוק. הפעם, גם הבדיקות העצמאיות תומכות בחלק ניכר מההבטחות.
ההשקה, שהתקיימה ב-12 באוקטובר, מגיעה שישה שבועות בלבד אחרי Muse Spark 1.3, ומסמנת שינוי בסדר העדיפויות של מטא. במקום להסתפק במודלים מהירים וזולים יחסית, החברה מציגה מערכות שמיועדות להתמודד עם משימות מורכבות לאורך זמן: מפיתוח תוכנה ועד טיפול בתביעות ביטוח, ניתוח חוזים וביצוע מחקר פיננסי. לא רק לענות על שאלות, אלא גם לבצע את העבודה.
שמונה נקודות בשישה שבועות
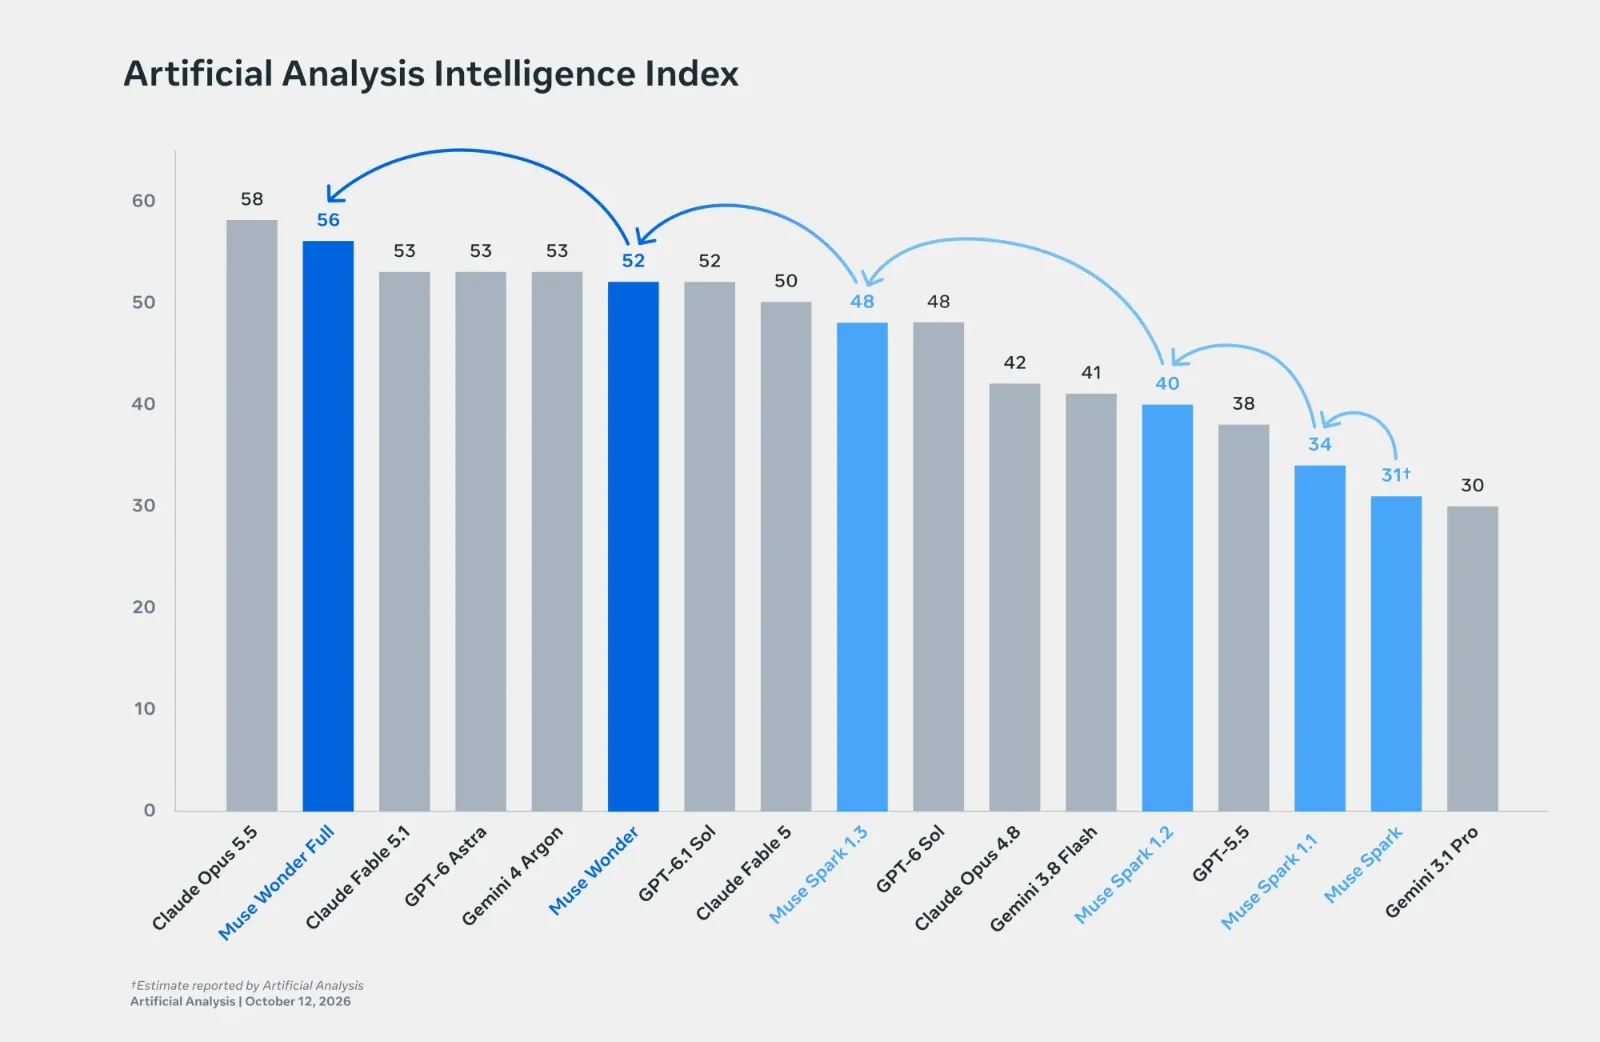
הנתון המרכזי בהשקה מגיע ממדד Artificial Analysis Intelligence Index, שמשקלל עשרה מבחני יכולת שונים. Muse Wonder Full השיג 56 נקודות, בהשוואה ל-58 נקודות של Claude Opus 5.5 במצב החשיבה המרבי. הוא השתווה ל-Claude Sonnet 5.5 באותה רמת חשיבה ועקף את GPT-6 Astra ואת Gemini 4 Argon, שקיבלו 53 נקודות כל אחד. הגרסה הרגילה, Muse Wonder, השיגה 52 נקודות, בעוד Muse Spark 1.3 הקודם הסתפק ב-48.
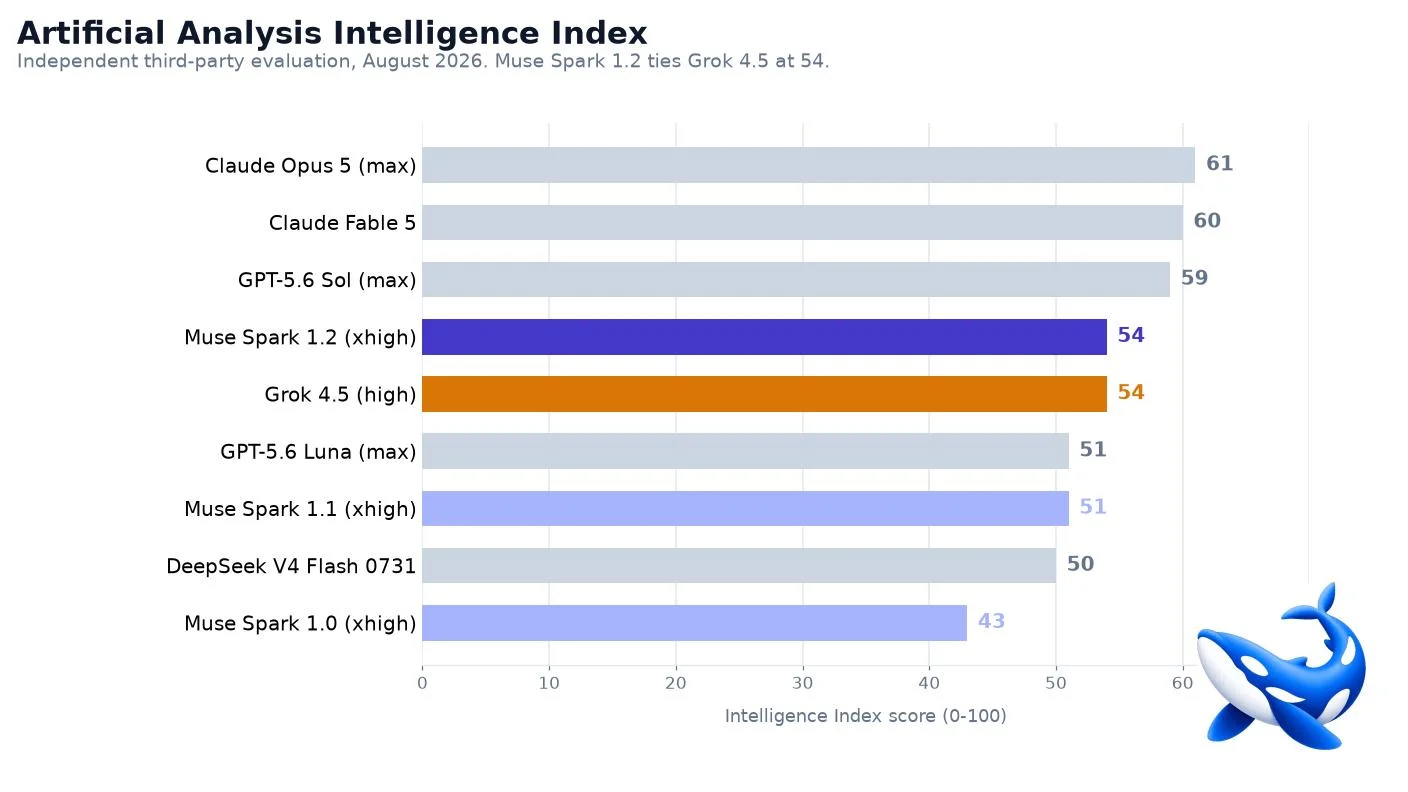
המספרים האלה מעניינים במיוחד משום שלא מדובר רק במדדים שמטא בחרה להציג בעצמה. בבדיקות העצמאיות, Muse Wonder Full נכנס לשלישייה המובילה בשישה מתוך עשרה מבחנים. הוא הציג יכולות חזקות במיוחד במשימות מקצועיות רב-שלביות, בניתוח מסמכים ובחשיבה מדעית.
אחת הדוגמאות הבולטות היא Terminal-Bench 4.0, שבוחן יכולת לבצע משימות תכנות בסביבת טרמינל. Muse Wonder Full הגיע להצלחה של 57%, לעומת 33% בלבד בדגם הקודם. במדד ייעודי לסוכני תכנות הוא קיבל 68 נקודות, בדומה ל-Claude Sonnet 5.5 כשהוא מופעל באמצעות Claude Code, ומעל Claude Opus 5.5 באותה סביבת בדיקה.
ועדיין, מוקדם להכתיר מנצחת חדשה. במדד שבוחן ידע כללי ודיוק עובדתי, Muse Wonder Full קיבל 30 נקודות בלבד, לעומת 46 ל-Claude Opus 5.5. במבחנים מסוימים של עבודה בטרמינל ובשאלות בריאות מורכבות הוא עדיין מפגר אחרי המתחרות. מנגד, שיעור ההזיות שנמדד בגרסת Full ירד ל-23%, נתון שמעיד על נטייה נמוכה יחסית להמציא תשובות כשהמודל אינו יודע את המידע הנדרש.
המשמעות היא שמטא הצליחה לסגור חלק גדול מהפער ביכולת לבצע עבודות מורכבות, אבל עדיין לא בנתה מודל שמוביל בכל תחום. עבור מפתחים, זו הבחנה חשובה: מודל שמתמודד היטב עם פרויקט תוכנה שנמשך שעות אינו בהכרח הבחירה הטובה ביותר לכל שאלה.
זיכרון פעיל והתמדה גם כשהמשימה מסתבכת
מאחורי השיפור עומדות שתי יכולות שמטא מכנה Active Memory ו-Active Focus. הראשונה נועדה לאפשר לסוכן הבינה המלאכותית לשמור מידע רלוונטי על המשתמש לאורך שיחות שונות, ולאחזר אותו כשצריך. השנייה מטפלת באחת הבעיות המוכרות של סוכני AI: הנטייה להיתקע מול שגיאה, לסטות מהמטרה או פשוט להפסיק לעבוד לפני שהמשימה הסתיימה.
למשל, משתמש יכול לבקש מ-Muse Wonder לבנות אפליקציה, להגדיר את הדרישות, ולעבור לעיסוקים אחרים. הסוכן אמור לפרק את הפרויקט לשלבים, להפעיל כלי פיתוח, לבדוק את התוצאות ולנסות פתרונות חלופיים אם משהו נכשל. כשנדרשת החלטה משמעותית, הוא אמור לחזור למשתמש לקבלת אישור. הרעיון הוא להחליף חלק מהפיקוח הצמוד שנדרש כיום מסוכני תכנות בפעולה עצמאית ומבוקרת יותר.
שני המודלים תומכים בחלון הקשר של כ-1.05 מיליון טוקנים, המאפשר להם לעבד כמויות גדולות של קוד ומסמכים בבקשה אחת. הם מסוגלים לקבל טקסט, תמונות, אודיו ווידאו, אף שהפלט בשלב זה טקסטואלי בלבד. מטא אינה חושפת את מספר הפרמטרים של המודלים, וגם אינה מציעה את המשקלים שלהם להורדה חופשית, בניגוד לגישה המזוהה עם משפחת Llama שלה.
הזיכרון המתמשך מעלה גם שאלות פרטיות. סוכן שמסוגל לגשת ליומן, להודעות ולמסמכים אישיים צריך לדעת לא רק מה לבצע, אלא גם מתי לעצור. הנושא אינו תיאורטי: Muse כבר נקשר למקרים שבהם מידע אישי נחשף או פעולות בוצעו ללא אישור ברור של המשתמש.
מטא מבטיחה שהמודלים החדשים אומנו להימנע משיתוף מידע פרטי ללא הרשאה, לזהות בקשות מזיקות ולהתמודד עם ניסיונות להטעות אותם באמצעות הוראות זדוניות. דוח בטיחות מפורט נוסף עדיין לא פורסם, ולכן מוקדם לקבוע עד כמה ההגנות החדשות יעילות בשימוש ממושך בעולם האמיתי.
מודל חזק יותר, אבל גם יקר יותר
Muse Wonder זמין כבר עכשיו למפתחים באמצעות Meta Model API וכלי התכנות Muse Code. המחיר הוא 4 דולרים למיליון טוקנים של קלט, 20 דולרים למיליון טוקנים של פלט ו-20 סנט למיליון טוקנים של קלט שנשלף מהמטמון. מדובר בתמחור ברמה של Claude Opus 5.5, וגבוה משמעותית מזה של Muse Spark 1.3. למעשה, לפי המדידות העצמאיות, עלות ביצוע משימה ממוצעת במדד הביצועים עלתה מ-1.60 דולר בדור הקודם ל-4.52 דולרים ב-Muse Wonder.
הגרסה החזקה יותר, Muse Wonder Full, אינה זמינה כרגע דרך ה-API הרגיל. הגישה אליה מוגבלת למנויי Muse Code במסלולי Power Usage ו-Maximum Usage, שעולים 50 ו-200 דולר בחודש בהתאמה. הראשון מיועד לעבודת פיתוח אינטנסיבית, בעוד השני מציע מכסת שימוש גדולה פי ארבעה מזו של מסלול Power.
בהמשך מתכננת מטא לשלב את Muse Wonder גם בסוכן האישי Muse, שכבר צבר מיליוני הורדות מאז השקתו בספטמבר. תחילה הוא יגיע למנויים משלמים, במסלולים של 20 ו-100 דולר בחודש, ובהמשך צפויות גרסאות ייעודיות לקהל הרחב. בשלב זה לא פורסם לוח זמנים מדויק להפצה הרחבה או פרטים נפרדים לגבי זמינות בישראל ותמיכה בעברית.
מאחורי ההשקה מסתתר שינוי עסקי לא פחות מעניין מהשיפור הטכנולוגי. במשך שנים מטא ניסתה לבסס את השפעתה בשוק ה-AI באמצעות הפצת מודלים עם משקלים פתוחים ושילוב בינה מלאכותית במוצרים קיימים. כעת היא גם מוכרת גישה ישירה למודלים סגורים, שירותי API ומנויים לכלי פיתוח. זו דרך חדשה לייצר הכנסות מההשקעות הכבדות בתשתיות ובכוח אדם, ולא להסתמך רק על הערך העקיף שה-AI מייצר למערכות הפרסום שלה.
מבחינת התחרות, השאלה המעניינת כבר אינה אם מטא מסוגלת לבנות מודל שמתקרב לביצועים של OpenAI ואנת'רופיק. התוצאות החדשות מראות שהיא מסוגלת. המבחן הבא יהיה להפוך את היכולת הזאת למוצר שאנשים באמת משתמשים בו לאורך זמן, במחיר שמצדיק את עצמו ועם רמת אמינות שמאפשרת להפקיד בידיו משימות אמיתיות.
עבור חברה שכבר מפעילה שירותים המשמשים מיליארדי אנשים, המרחק בין מודל AI מצוין למוצר מצליח עשוי להיות קצר מאוד. אבל הפעם מטא תצטרך להוכיח שהסוכן שלה יודע לא רק לענות טוב יותר מהמתחרים, אלא גם לסיים את העבודה בלי שהמשתמש יצטרך לבדוק אותו בכל שלב.