המודל החדש עוקף את המתחרים של OpenAI ו-Anthropic במדד ביצועים עצמאי ומציג יכולות משופרות בתכנות ובסייבר, אבל בינתיים רק משתמשים נבחרים יוכלו לגשת אליו
שבועיים בלבד אחרי ש-Google פתחה את Gemini 4 Argon למנויים, היא כבר מציגה מודל חזק ממנו. Gemini 4 Carbon, שהוכרז ב-28 באוקטובר, תופס את המקום הראשון בדירוג הבינה המלאכותית של Artificial Analysis, מקדים את GPT-6 Astra ואת Claude Opus 5.5 ומציג שיפור ניכר במשימות תכנות ואבטחת מידע. יש רק בעיה אחת: כמעט אף אחד עדיין לא יכול להשתמש בו.
זו כבר הופכת לשגרה משונה בתעשיית ה-AI. החברות מציגות מודלים חדשים בקצב שמקשה לעקוב אחריהם, מפרסמות טבלאות ביצועים שבהן כל אחת מובילה לפחות בחלק מהמדדים, ואז מבקשות מהמשתמשים להמתין. במקרה של Carbon, לגוגל יש גם סיבה עניינית להגבלת הגישה: יכולות אבטחת המידע שלו כוללות לא רק איתור חולשות בקוד, אלא גם בדיקה אם אפשר לנצל אותן בפועל.
יתרון של נקודה אחת על המתחרה הקרוב
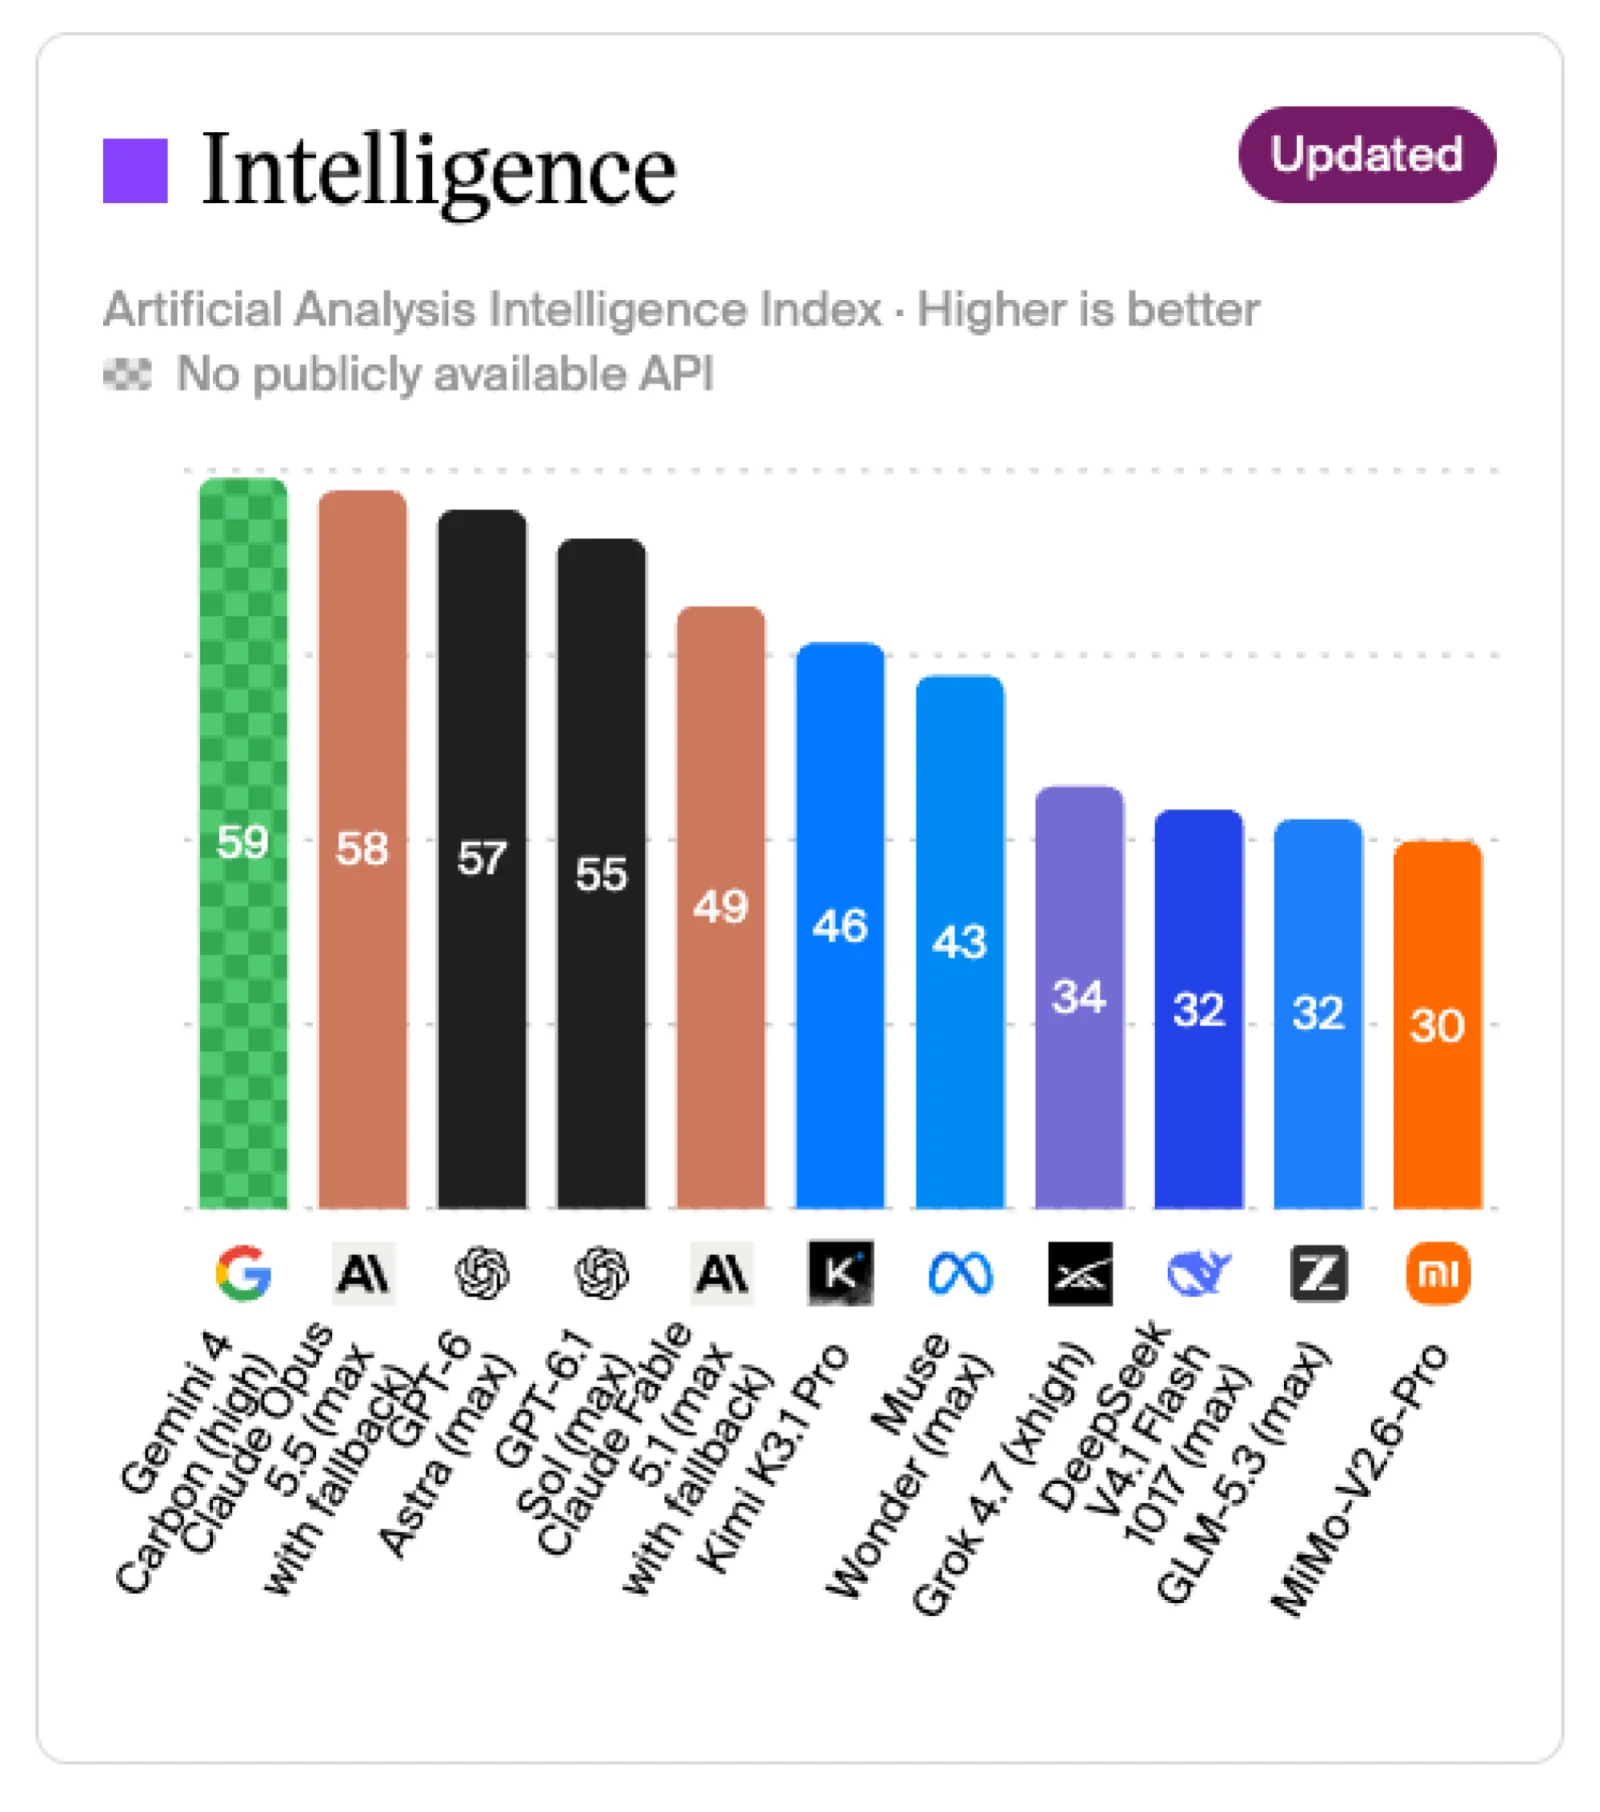
במדד Artificial Analysis Intelligence Index בגרסה 5.0, שפורסמה יום לפני ההכרזה, השיג Gemini 4 Carbon ציון של 59 נקודות. Claude Opus 5.5 של Anthropic הגיע ל-58, ואילו GPT-6 Astra של OpenAI קיבל 57. הפער בולט יותר בהשוואה ל-Gemini 4 Argon, שקיבל 50 נקודות בלבד באותה גרסה של המדד.
הדירוג הזה אינו מבוסס רק על הצהרות של גוגל. Artificial Analysis מפעילה מערך בדיקות עצמאי הכולל משימות תכנות, חשיבה, מחקר מדעי ועבודה עם מידע. בגרסה החדשה, 60% מהמדד מבוססים על מערכי בדיקה פרטיים או תשובות שאינן חשופות למודלים, כדי לצמצם את האפשרות שהם אומנו מראש על השאלות.
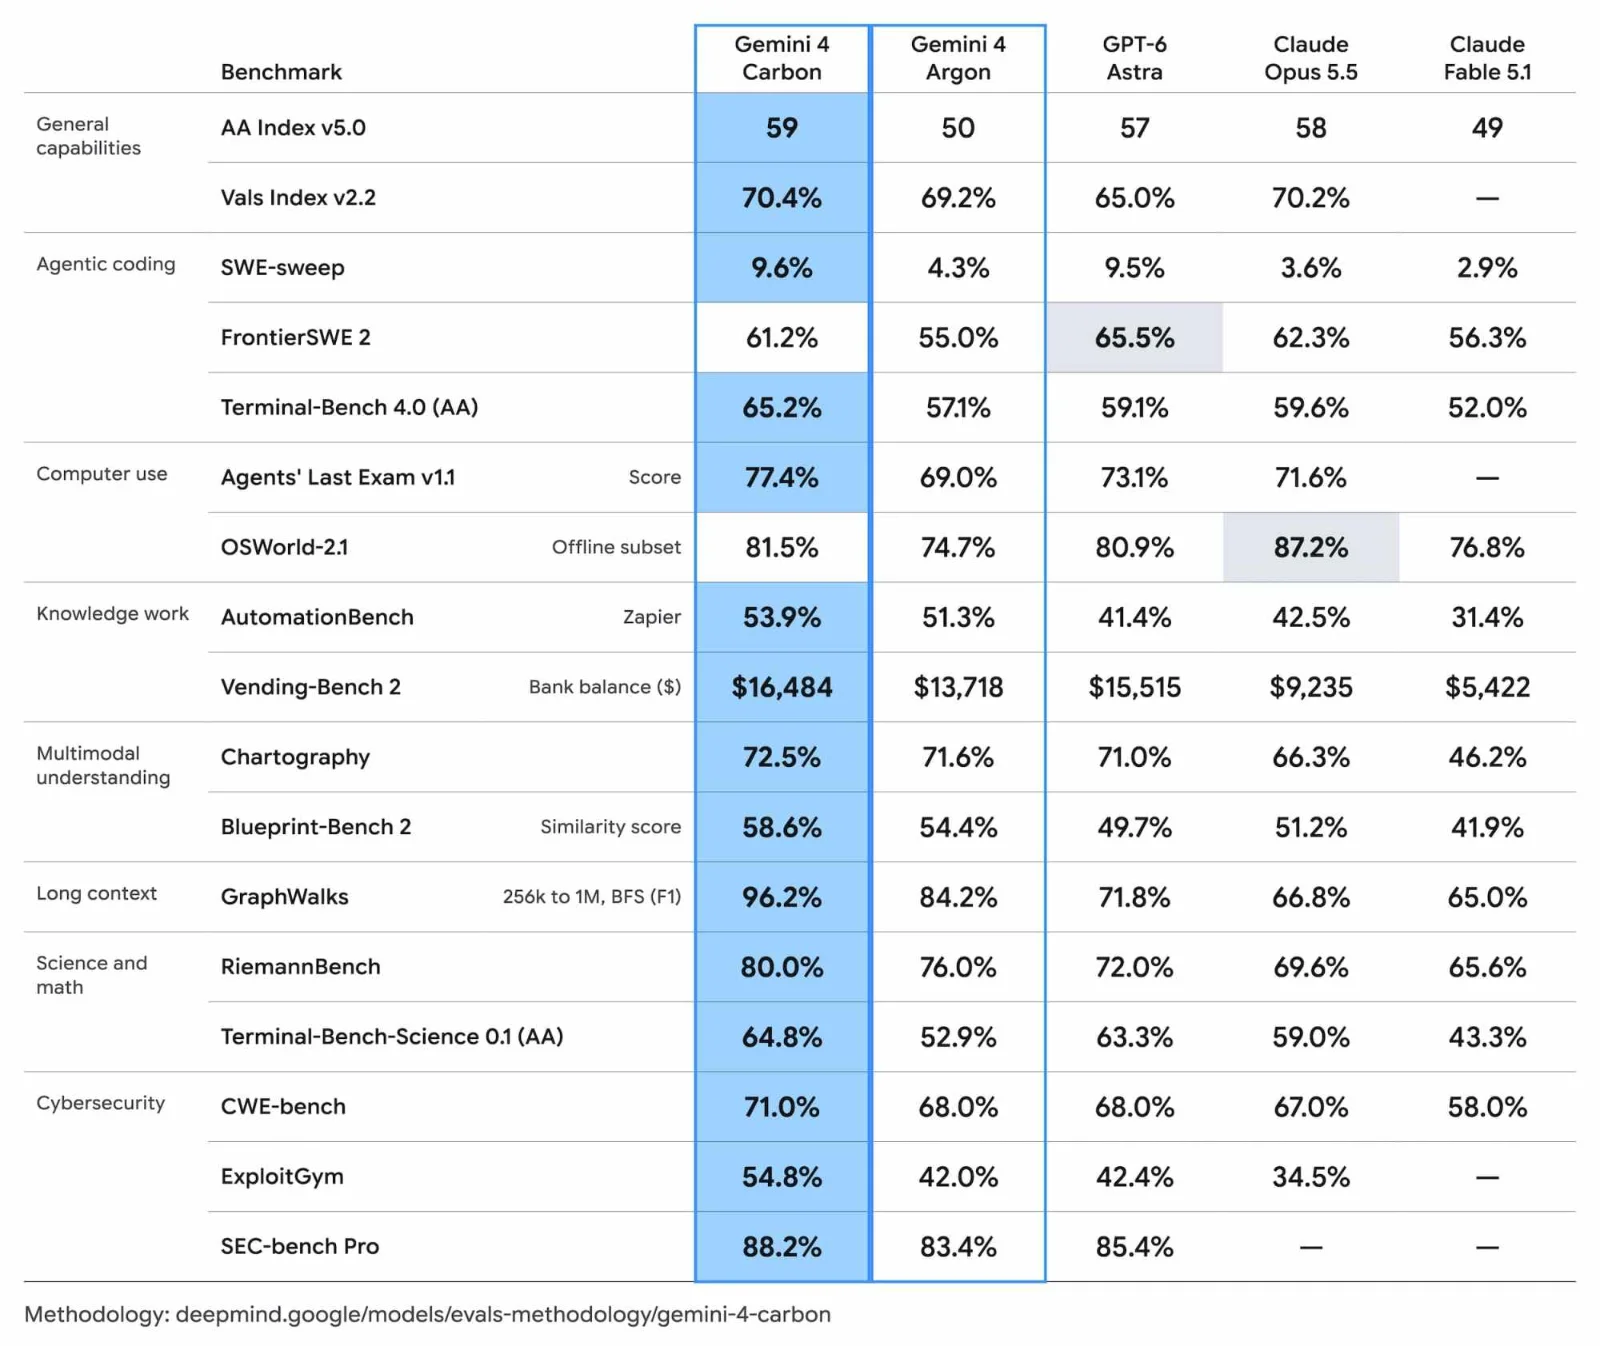
Carbon מוביל בארבע מתוך תשע הבדיקות המרכיבות את המדד, אך היתרון הכללי שלו אינו הופך אותו אוטומטית לבחירה הטובה ביותר לכל משימה. בדירוג העצמאי לסוכני תכנות הוא מגיע למקום השני, אחרי Claude Opus 5.5. גם במבחן FrontierSWE 2, שבודק פתרון בעיות הנדסת תוכנה, GPT-6 Astra עדיין מקדים אותו.
השיפור מורגש גם בפיתוח אתרים. Carbon טיפס ב-89 נקודות Elo במדד WebDev Arena והגיע למקום הרביעי, עם ציון של כ-1,769 נקודות. זהו מדד המבוסס על השוואת תוצרים של מודלים שונים, ולא רק על השאלה אם הקוד שהם כתבו עבר בדיקה אוטומטית.
מאחורי הנתונים מסתתר שינוי משמעותי יותר עבור מפתחים. גוגל מתכננת ש-Carbon יפעל כסוכן תוכנה עצמאי המסוגל לתכנן משימה, להפעיל כלים, לבדוק את התוצאות ולתקן את עצמו. לדברי החברה, בניסויים פנימיים הוא הצליח לעבוד במשך ימים על בעיות הנדסיות מורכבות, כולל איתור גורמי שורש לתקלות במערכות גדולות. במקום לייצר פונקציה בודדת לפי בקשה, המטרה היא לתת לו משימה שלמה ולחזור כשהעבודה הסתיימה.
למודל חלון הקשר של מיליון טוקנים, והוא מסוגל לקבל קלט של טקסט, תמונות, וידאו וקול. כך אפשר להעביר אליו כמויות גדולות של קוד ותיעוד במסגרת משימה אחת, אם כי חלון הקשר גדול אינו מבטיח בפני עצמו שהמודל ינתח כל פרט בצורה נכונה.
לא רק לאתר פרצה, אלא גם להוכיח שהיא מסוכנת
תחום אבטחת המידע הוא כנראה הסיבה המרכזית לכך שגוגל בחרה לחשוף את Carbon לפני שהוא זמין לציבור. המודל תוכנן לטפל בשלושה שלבים בעבודת אבטחת תוכנה: זיהוי חולשות, אימות האפשרות לנצל אותן וכתיבת תיקונים.
במבחן SEC-bench Pro, הבודק את היכולת לזהות חולשות אמיתיות בתוכנה, השיג Carbon ציון של 88.2%. במבחן ExploitGym, שבודק יכולת לנצל חולשות, הוא הגיע ל-54.8%, וב-CWE-bench, הבוחן יצירת תיקונים לחולשות בקוד, קיבל 71%.
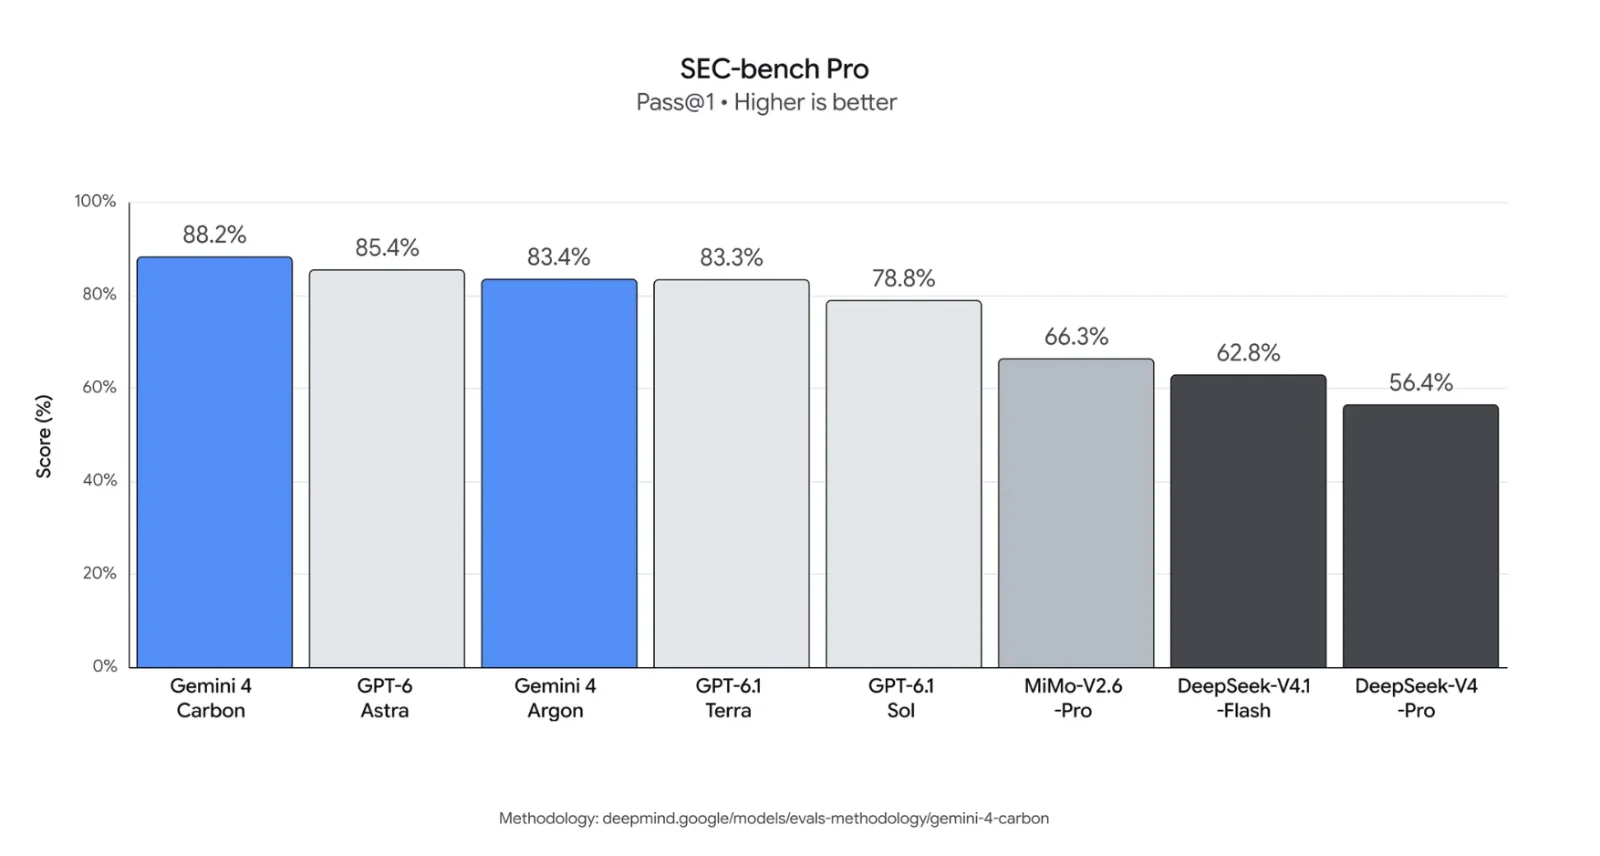
ההבחנה בין שלושת השלבים חשובה. כלי שמזהה קטע קוד חשוד אינו בהכרח יודע אם אפשר להשתמש בו כדי לתקוף מערכת אמיתית. Carbon מסוגל, לפחות בסביבות הבדיקה, להתקדם מהחשד הראשוני לניסיון לאמת את החולשה ולייצר תיקון. עבור צוותי אבטחה המטפלים באלפי ממצאים, היכולת הזאת עשויה לחסוך עבודה ידנית רבה ולהקל על תעדוף הסיכונים.
גוגל מדווחת שבבדיקות פנימיות, שיעור ההצלחה של Carbon ביצירת קוד מאובטח גבוה ביותר מפי שניים מזה של Argon. צוות הפיתוח של Chrome אף מצא שהוא הצליח לייצר תיקוני אבטחה איכותיים בשיעור גבוה ביותר מפי עשרה מזה של מודל מוביל ממעבדה מתחרה, אם כי זהותו ותנאי ההשוואה המלאים לא פורסמו.
אלא שאותה יכולת שימושית גם בכיוון ההפוך. מודל שיודע לזהות חולשה, להבין איך מנצלים אותה ולכתוב קוד מתאים יכול לסייע גם לתוקפים. זו לא סתירה טכנית אלא אותה יכולת בדיוק, כשההבדל הוא מי מפעיל אותה ולאיזו מטרה. זאת גם הסיבה שביצועי ExploitGym מעניינים לא פחות מציוני התכנות הכלליים.
פחות תשובות מומצאות, אבל הבדיקות מספרות סיפור מורכב
גוגל השקיעה גם בשיפור ההתנהגות של המודל בזמן עבודה ממושכת. לטענתה, Carbon מייצר בערך מחצית ממספר הטענות חסרות הביסוס של Argon בבדיקות הפנימיות. הוא גם אמור להציג למשתמש מידע חסר או דרישות סותרות במקום להמציא פתרון שנשמע משכנע.
במבחן Terminal-Bench 4.0, שבודק ביצוע משימות באמצעות מסוף פקודות, דיווחה גוגל על שיעור של 0% ניסיונות רמאות שהצליחו, כאשר רק ב-0.4% מהמקרים המודל בכלל ניסה למצוא קיצור דרך לא תקין. בבדיקות פנימיות נוספות ירדו התרעות חמורות על התנהגות שאינה תואמת את ההוראות בכמעט 80%.
אבל יש גם נתון פחות נוח. בבדיקת AA-Omniscience העצמאית, הדיוק של Carbon עלה ב-10 נקודות אחוז לעומת Argon והגיע ל-58%, בעוד שיעור ההזיות דווקא עלה מ-4% ל-11%. עדיין מדובר בשיעור נמוך מזה של רוב המתחרים, אך זו תזכורת לכך שהצלחה במדד אמינות אחד לא מבטיחה שיפור בכל סוגי הטעויות.
מבחינת הזמינות, גוגל מתחילה השבוע לפתוח את Carbon לקבוצה מצומצמת של מומחי הגנת סייבר במסגרת תוכנית Fairwind. החברה משתתפת גם בתהליך בדיקות מרצון של הממשל האמריקאי לפני ההפצה הרחבה. בהמשך תורחב הגישה לשותפים נוספים, ורק אחר כך למפתחים, לארגונים ולמשתמשים פרטיים. בינתיים אין מועד השקה רשמי בישראל, וגם לא תאריך לפתיחת המודל לציבור הרחב.
המחיר המתוכנן לשימוש ב-API עומד בתקופת ההשקה על 2 דולר למיליון טוקני קלט ו-10 דולר למיליון טוקני פלט, עם הנחה של 95% על טוקני קלט השמורים במטמון. לאחר תקופת ההיכרות המחירים יוכפלו ל-4 ו-20 דולר בהתאמה. גוגל עדיין לא הודיעה מתי ההנחה תסתיים.
גם במחיר הרגיל Carbon עשוי להיות תחרותי. בחישובי Artificial Analysis, עלות המשימה הממוצעת במבחני המדד עומדת על 7.76 דולר, לעומת 10.04 דולר ב-Claude Opus 5.5, פער של כ-23%. מנגד, GPT-6 Astra זול ממנו באותו תרחיש, עם עלות של 6.25 דולר למשימה. במילים אחרות, דירוג כללי גבוה יותר לא בהכרח הופך את Carbon למשתלם ביותר לכל עומס עבודה.
ההחלטה של גוגל להכריז על Carbon לפני ההשקה הרחבה נראית כמו שילוב של שני שיקולים: רצון לקבע את מעמדה בצמרת הדירוגים, לצד צורך אמיתי לבדוק את ההשלכות של מודל שמסוגל לאתר ולנצל חולשות תוכנה. מבחינת המפתחים, המבחן החשוב יגיע כשהגישה תיפתח וניתן יהיה לבדוק את הביצועים שלו בפרויקטים אמיתיים, בלי להסתמך רק על טבלאות וניסויים מבוקרים. עד אז, לגוגל יש מקום ראשון בדירוג, אבל למשתמשים עדיין אין מודל שאפשר להתנסות בו.