במבחן המבוסס על מקרי חדר מיון הגיעה MAI-DxO לדיוק של 83% מול 36% אצל רופאים, וכעת מתוכננים ניסויים קליניים
כשרופאים מנוסים קיבלו תיקים רפואיים מורכבים ונדרשו להגיע לאבחנה, הם הצליחו לזהות נכון את המחלה ב-36% מהמקרים, גם כשעמדו לרשותם מקורות מידע רפואיים. מערכת הבינה המלאכותית של Microsoft הצליחה ב-83% מאותם סוגי מקרים. בלי שנים של התמחות, בלי משמרות בבית חולים ובלי להתקשר למומחה להתייעצות. אלו התוצאות שמציגה החברה במחקר חדש שעבר ביקורת עמיתים, והן מציבות שאלה לא נוחה במיוחד בפני עולם הרפואה: עד כמה אנחנו עדיין זקוקים לרופא אנושי כדי לפענח מה בדיוק לא בסדר?
Microsoft מציגה את הממצאים כחלק מהמאמץ שלה לפתח "בינת-על רפואית", אבל הסיפור כאן מעניין יותר מעוד מודל AI שמקבל ציונים גבוהים במבחן. מערכת האבחון שלה, שנקראת MAI Diagnostic Orchestrator או בקיצור MAI-DxO, אינה מסתפקת בניתוח רשימת תסמינים. היא מחליטה אילו שאלות לשאול, אילו בדיקות להזמין, מתי לפסול אבחנה אפשרית ומתי יש מספיק מידע כדי לקבוע מה הבעיה. והפעם, היא הצליחה לעשות זאת גם בעלות נמוכה יותר.
חמישה רופאים וירטואליים, מודל שפה אחד
היתרון של MAI-DxO לא נובע רק מהמודל שמפעיל אותה, אלא מהאופן שבו Microsoft מארגנת את תהליך החשיבה שלו. במקום לשלוח את התסמינים ל-GPT-5 ולבקש אבחנה, המערכת מפעילה צוות של סוכני AI בעלי תפקידים שונים. אחד מגבש השערות לגבי מחלות אפשריות, אחר בוחר בדיקות שיכולות לאשש או לשלול אותן, שלישי מחפש סתירות במסקנות, ורביעי בוחן את העלויות ואת הצורך בכל בדיקה. סוכן נוסף אחראי לבקרת איכות.
כל סוכן בוחן את המקרה מזווית אחרת, והמערכת מתאמת ביניהם כמה סבבי דיון עד לקבלת החלטה. זה דומה להתייעצות בין רופאים ממחלקות שונות, רק שכאן מדובר בתהליך תוכנה הנשען על מודל שפה. אחד היתרונות הוא היכולת לערער על השערה שכבר נראית משכנעת, במקום להמשיך לחפש רק ראיות שמחזקות אותה.
הגישה הזו מטפלת באחת החולשות של מודלי שפה באבחון רפואי. מודל שמתבקש לספק תשובה מיידית עלול להינעל על ההסבר הראשון שמתאים לתסמינים. MAI-DxO, לעומתו, נדרשת לאסוף ראיות באופן מדורג. אם בדיקת דם אינה מתאימה להשערה הראשונית, היא יכולה לשנות כיוון לפני שתגיע לאבחנה סופית.
כדי לבדוק את היכולת הזאת פיתחה Microsoft את SDBench, סביבת ניסוי שבה גם רופאים וגם מערכות AI מתחילים עם תיאור קצר של המטופל. הם רשאים לשאול שאלות, לבקש תוצאות מעבדה ולהזמין בדיקות נוספות, אך אינם מקבלים מראש את כל המידע. מערכת נפרדת חושפת את הנתונים שהתבקשו ומחשבת את העלות המצטברת של הבדיקות. במקרים שבהם המידע המקורי אינו כולל תוצאה של בדיקה מסוימת, הסביבה יכולה גם לייצר תוצאה סינתטית שמתאימה לתיק הרפואי.
ההבדל הזה משמעותי. מבחני AI רפואיים רבים דומים לשאלות אמריקאיות שבהן כל הנתונים כבר מופיעים מול הנבחן. SDBench בודקת גם את הדרך אל התשובה, ולא רק את התשובה עצמה. רופא טוב אינו מי שמצליח לנחש את המחלה מהרשימה, אלא מי שיודע איזה מידע חסר לו ואיך להשיג אותו בלי לשלוח את המטופל לכל בדיקה אפשרית.
גם בחדר המיון היתרון נשמר
המחקר בחן תחילה 304 מקרי אבחון מורכבים שנבחרו מתוך תיאורי מקרים רפואיים שפורסמו לאורך השנים. MAI-DxO הגיעה לדיוק של 83%, לעומת 22% בלבד אצל רופאים שפעלו ללא מקורות מידע חיצוניים ו-36% אצל רופאים שהורשו להיעזר בהם. זהו יתרון של יותר מפי שניים גם מול קבוצת ההשוואה שקיבלה גישה למידע רפואי.
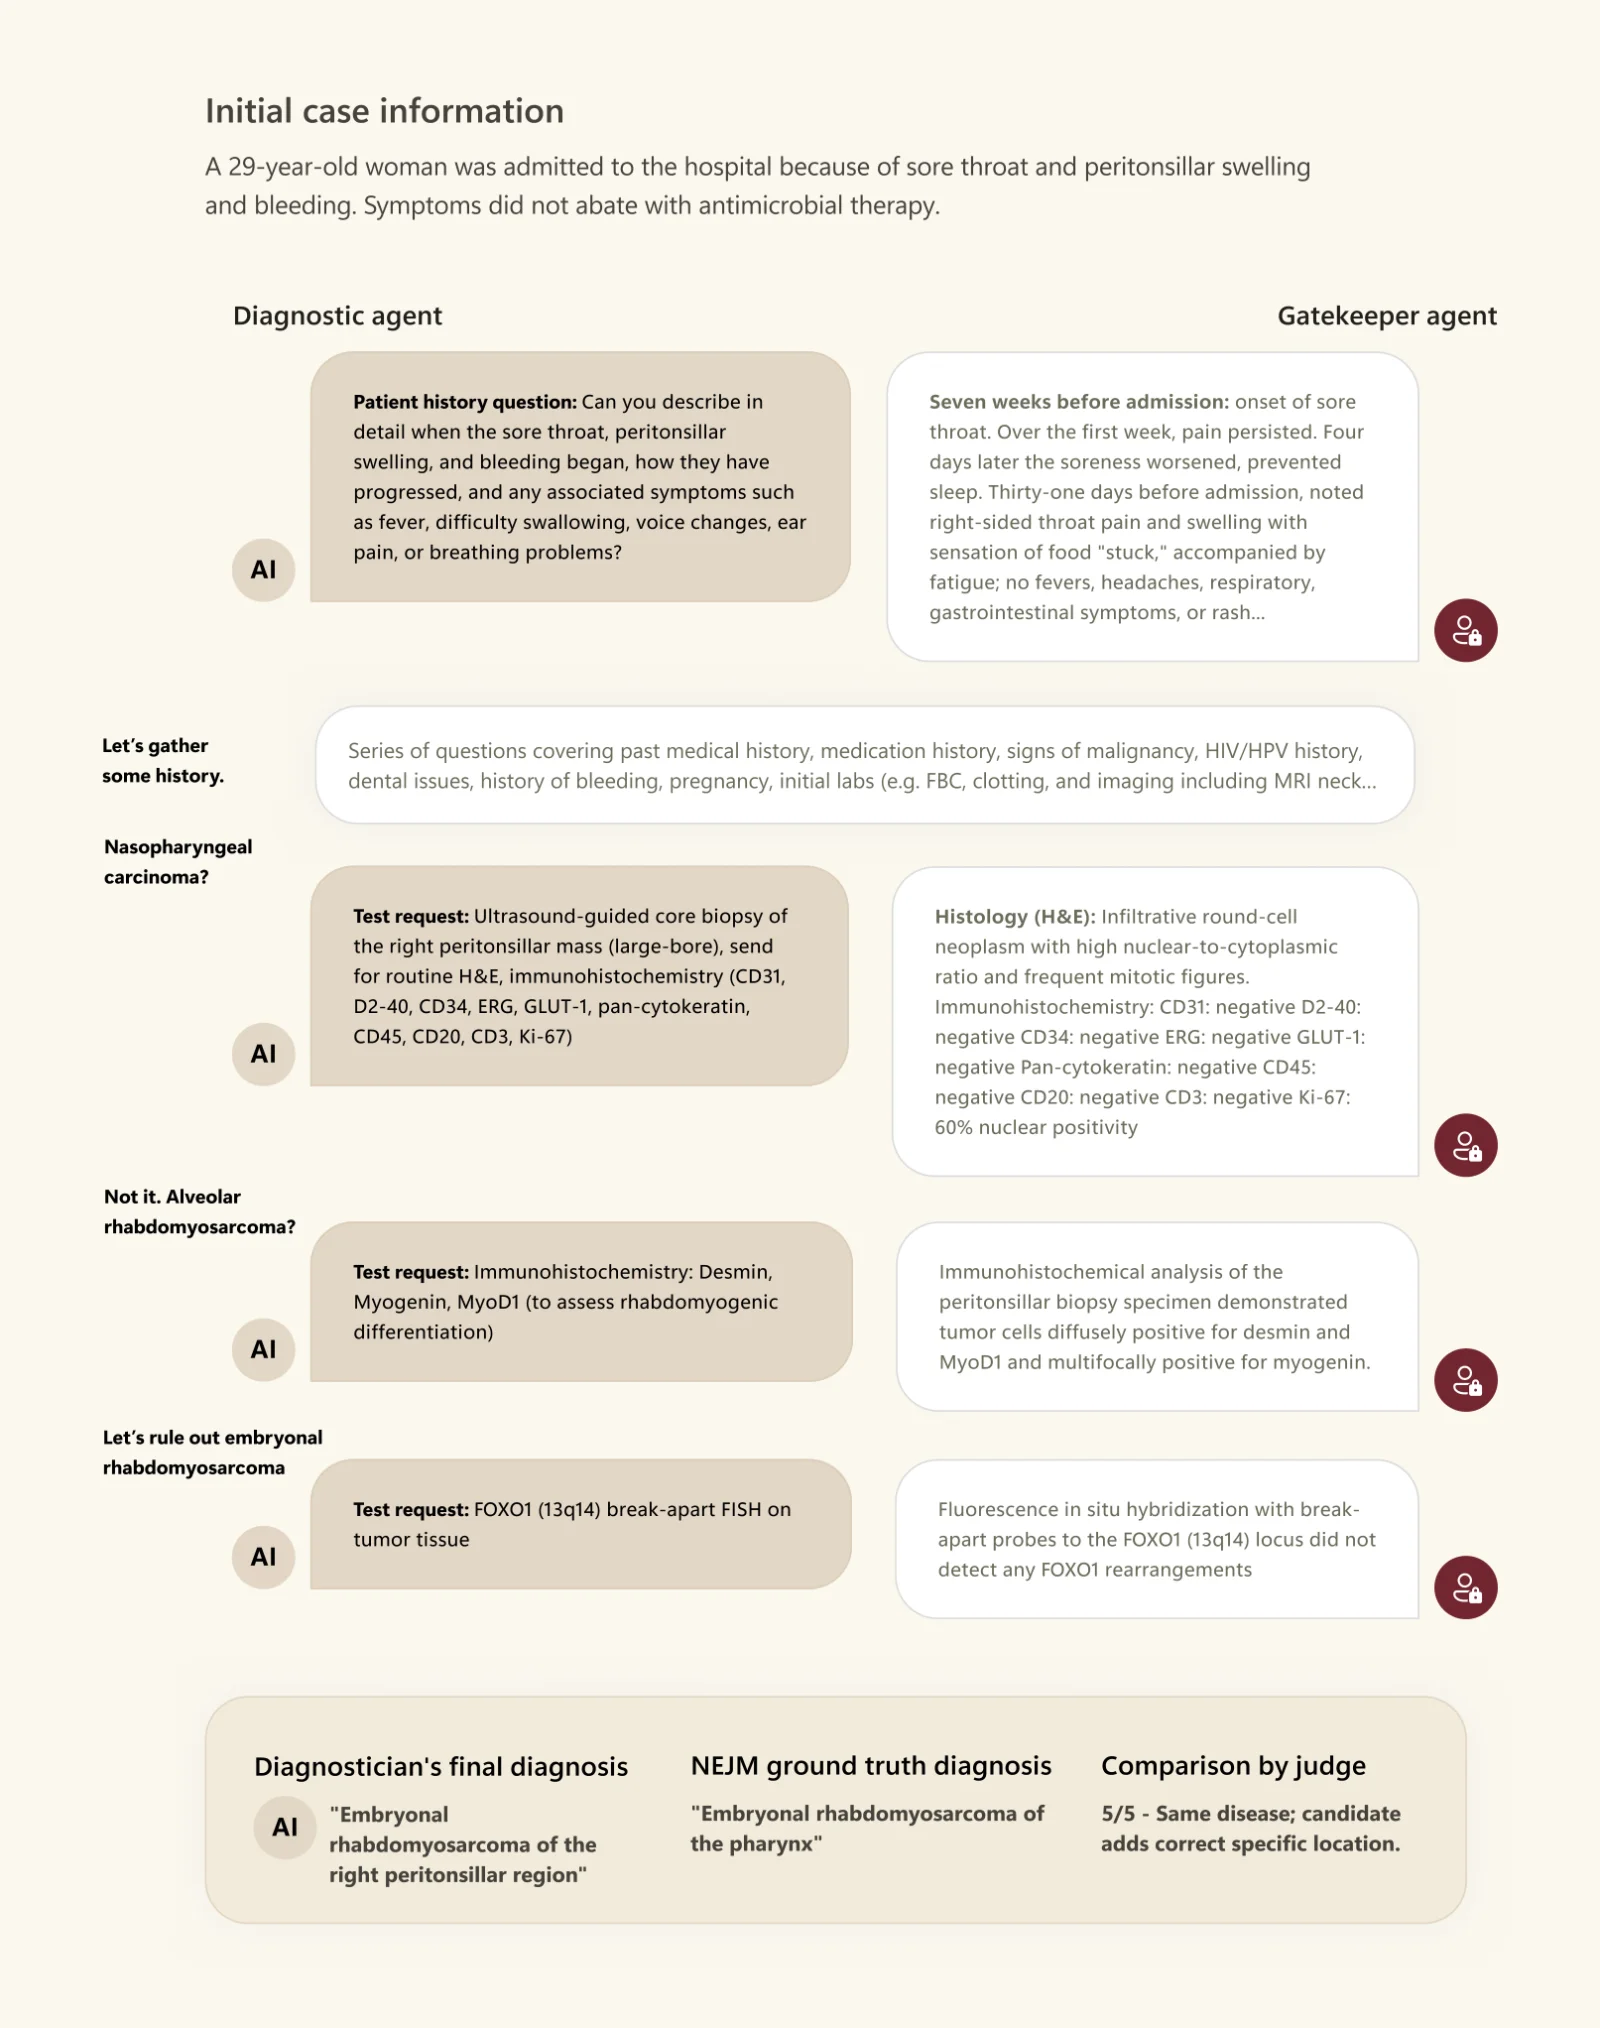
אבל המקרים האלה נבחרו בשל המורכבות שלהם. לא מדובר בהכרח בבעיות השגרתיות שמגיעות למרפאת משפחה, אלא במקרים שנועדו לאתגר גם רופאים מנוסים. לכן Microsoft הרחיבה את הבדיקה גם למאגר MIMIC-IV-ED, המבוסס על תיקים של מטופלים בחדר המיון של המרכז הרפואי Beth Israel Deaconess בבוסטון.
גם כאן התוצאות נטו לטובת המכונה, אם כי הפער היה קטן יותר: 80% אבחנות נכונות למערכת של Microsoft לעומת 47% אצל הרופאים, יתרון של פי 1.7. זו תוצאה משמעותית במיוחד משום שהמקרים האלה קרובים יותר למצבים רפואיים נפוצים מאשר חידות האבחון המורכבות ששימשו בבדיקה הראשונה.
ויש גם את עניין הכסף. Microsoft מדווחת כי בחלק מתצורות ההפעלה MAI-DxO הצליחה להגיע לדיוק של 81% במקרים המורכבים, תוך שימוש בתקציב בדיקות הנמוך ממחצית העלות של מערכות ההשוואה. במקום להזמין בדיקות יקרות כדי לצמצם כל ספק אפשרי, הסוכנים שוקלים את התרומה הצפויה של כל בדיקה להחלטה הסופית. העלויות במחקר הן הערכות המבוססות על תמחור רפואי, ולא חיסכון שכבר נמדד בבתי חולים פעילים.
מעניין גם שהמערכת אינה תלויה בדור מסוים של מודלי שפה. המחקר המרכזי התבסס על GPT-5, אך Microsoft דיווחה שבדיקות נוספות עם GPT-5.5 שיפרו את הביצועים בלי לשנות את שיטת התזמור. המשמעות היא שחלק מהיתרון עשוי להגיע לא מהגדלת המודל עצמו, אלא מהכפפתו לתהליך עבודה שמאלץ אותו לחשוב באופן שיטתי.
עכשיו מגיע המבחן שהסימולציה לא יכולה להחליף
לפני שממהרים להכריז על סוף עידן הרופא האנושי, יש הבדל מהותי בין הצלחה בסביבת מחקר לבין טיפול במטופל אמיתי. המקרים במחקר נשענים על מידע רפואי שתועד בעבר, והמערכת פועלת בתוך סביבה שמאפשרת לה לבקש מידע ולקבל תשובות מובנות. במרפאה אמיתית מטופלים לא תמיד זוכרים מתי התחילו התסמינים, בדיקות עלולות להניב תוצאות לא חד-משמעיות, ולעיתים ההחלטה החשובה ביותר היא דווקא לזהות שמדובר במצב חירום.
יש גם מגבלה נוספת: מערכת שמגיעה לאבחנה נכונה אינה בהכרח מערכת שיודעת לבחור את הטיפול המתאים, לנהל סיכונים רפואיים או להסביר למטופל מה משמעות האפשרויות העומדות בפניו. אבחון הוא שלב מרכזי ברפואה, אבל הוא רק חלק מתהליך הטיפול.
Microsoft מודעת לפער הזה ומתכננת להתחיל לבחון את MAI-DxO בסביבה קלינית אמיתית, בשיתוף Beth Israel Deaconess Medical Center. במסגרת המחקר העתידי מטופלים יתקשרו ישירות עם המערכת, והתוצאות יושוו להערכות עצמאיות של רופאים. החברה עדיין לא הכריזה על מועד השקה מסחרי, והכלי אינו זמין לציבור, גם לא בישראל.
במקביל, Microsoft מתחילה לפתוח את SDBench לחוקרים חיצוניים, כולל הקוד שאחראי להצגת המקרים, לבחינת התשובות ולהערכת העלויות. חלק ממאגרי המקרים עצמם מחייבים רישיונות או הרשאות גישה נפרדות. האפשרות לבצע בדיקות חוזרות ובלתי תלויות חשובה במיוחד בתחום שבו טעות באבחנה עלולה להוביל לטיפול שגוי, לעיכוב בטיפול או לבדיקות מיותרות.
מוסטפא סולימאן, מנכ"ל חטיבת Microsoft AI, מעריך שבתוך שנים ספורות ניתן יהיה להגיע למערכת רפואית שביצועיה יהיו בלתי ניתנים להבחנה מביצועים אנושיים. הוא עדיין רואה ברופאים חלק מרכזי מתהליך הטיפול, אך מצפה שהטכנולוגיה תצמצם את העבודה השגרתית ותאפשר להם להקדיש יותר זמן למטופלים.
ההערכה הזאת שאפתנית, אבל התוצאות החדשות כבר מצביעות על כיוון מעשי יותר. במקום לנסות להחליף רופא במודל שפה אחד שיודע לענות על כל שאלה, Microsoft בונה מערכת שמחקה את שיתוף הפעולה בין אנשי מקצוע ומנצלת אותו כדי להגיע להחלטות מדויקות וחסכוניות יותר. אם היתרון הזה ישרוד את המעבר מהסימולציה לבית החולים, השאלה כבר לא תהיה אם AI יודעת לאבחן מחלות, אלא כיצד משלבים אותה בעבודה הרפואית בלי לוותר על האחריות האנושית.