תכנון שרתים חדש מאפשר להריץ אלפי סוכני בינה מלאכותית במקביל, עם אפשרות לשלב מאיצים גרפיים או להסתפק במעבדים מרכזיים בלבד
32,768 ליבות עיבוד בארון שרתים אחד, בלי צורך אפילו בכרטיס מסך אחד. זה המספר ש-AMD הציגה בכנס OCP Global Summit 2026, והוא מספר סיפור מעניין על הכיוון שאליו הולכת תעשיית הבינה המלאכותית. אחרי שנים שבהן כמעט כל הכרזה משמעותית בתחום ה-AI התמקדה במאיצים גרפיים, AMD מחזירה למרכז הבמה דווקא את המעבד המרכזי.
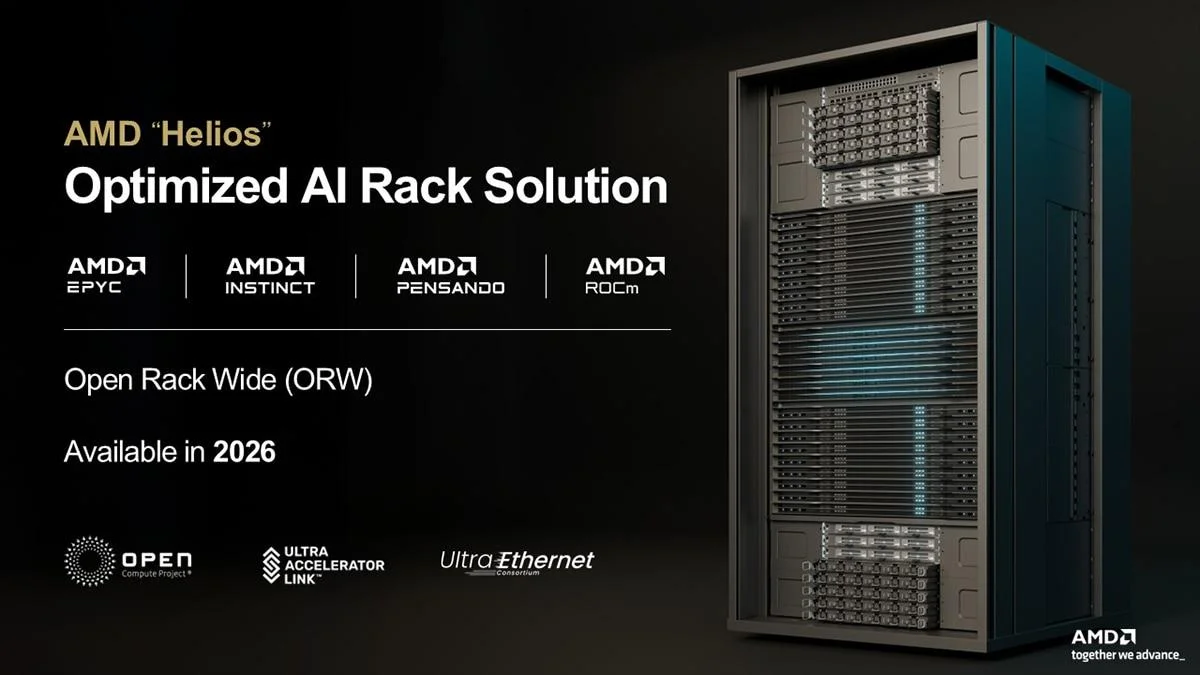
החברה חשפה שתי התפתחויות משלימות: Helion, תכנון חדש לארונות שרתים המיועדים להרצת אלפי סוכני בינה מלאכותית במקביל, ו-EPYC Verano, מעבד שרתים עתידי המבוסס על ארכיטקטורת Zen 6 ומשלב זיכרון LPDDR5X חסכוני בחשמל. מאחורי שתי ההכרזות עומדת אותה הבנה: ככל שמערכות AI מתחילות לבצע פעולות ולא רק לייצר תשובות, הן זקוקות להרבה יותר כוח עיבוד מסוג אחר.
32,768 ליבות, ולא בשביל להריץ צ'אט אחד
מערכת AMD Helion מבוססת על מעבדי EPYC 9006 מדור Venice, שהושקו מוקדם יותר השנה ומבוססים על ארכיטקטורת Zen 6 בתהליך ייצור של 2 ננומטר מבית TSMC. בתצורה הצפופה ביותר, כל ארון יכול להכיל עד 128 מעבדי EPYC 9996, שכל אחד מהם כולל 256 ליבות Zen 6c ו-512 נימים. התוצאה היא 32,768 ליבות ו-65,536 נימים בארון יחיד.
כדי להבין מדוע AMD זקוקה לכל כך הרבה ליבות, צריך להבחין בין מודל AI רגיל לבין סוכן AI אוטונומי, או Agentic AI. בעוד צ'אטבוט מסורתי בעיקר מקבל שאלה ומייצר תשובה, סוכן מתקדם יכול לפתוח סביבת עבודה, להריץ קוד, לגשת למסדי נתונים, להפעיל יישומים ולבצע רצף של פעולות עד להשלמת המשימה.
נניח שמשתמש מבקש מסוכן AI לתקן באג בתוכנה. המודל עצמו עשוי לפעול על מאיץ גרפי, אבל הסוכן צריך גם להוריד קוד, להריץ בדיקות, להתקין ספריות ולנתח את התוצאות. כל הפעולות האלה דורשות משאבי CPU, זיכרון ואחסון. כשאלפי משתמשים מפעילים סוכנים במקביל, מדובר כבר בתשתית מחשוב בפני עצמה.
במילים פשוטות, ה-GPU מספק את יכולת ההסקה של המודל, וה-CPU מאפשר לסוכן לבצע את העבודה שמסביב. אלפי הליבות של Helion לא נועדו בהכרח להאיץ משימה בודדת, אלא לאפשר למספר גדול של סוכנים לפעול במקביל, כל אחד בסביבת ביצוע מבודדת משלו.
מעבד EPYC 9996 כולל גם זיכרון מטמון L3 בנפח 1GB ותמיכה בזיכרון DDR5 דרך 16 ערוצים. הצפיפות הזאת מאפשרת ל-AMD להציע תשתית המבוססת על פחות שרתים פיזיים ביחס למספר הליבות, אם כי הביצועים בפועל תלויים גם בכמות הזיכרון, בתקשורת ובאופי המשימות.
שני מסלולים לעולם שבו לא כל משימה צריכה GPU
AMD תציע את Helion בשתי תצורות שונות. הראשונה מיועדת לספקיות ענן גדולות, והיא מבוססת על מעבדים מרכזיים בלבד. בתרחיש הזה, השרתים מריצים את הסוכנים ומעבירים בקשות למודלי AI הפועלים בתשתיות GPU נפרדות. כך ניתן להרחיב את מספר הסוכנים הפעילים בלי להוסיף מאיצים גרפיים לכל שרת.
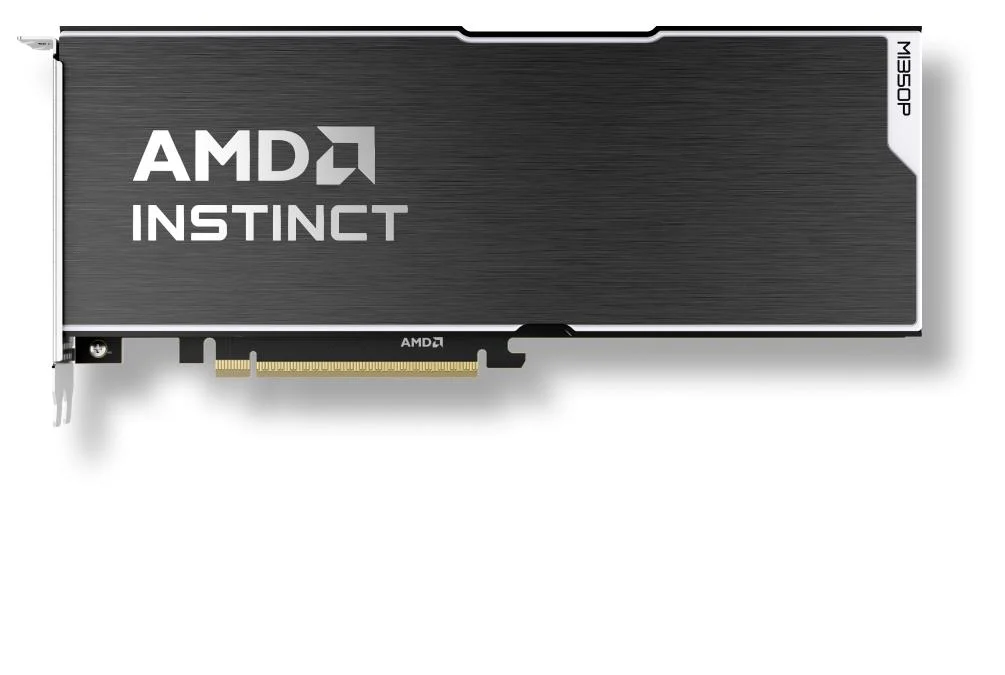
התצורה השנייה פונה לארגונים שמעוניינים בתשתית משולבת. כאן Helion משלבת מעבדי EPYC עם עד 16 מאיצי Instinct MI350P, לצד שרתים לטיפול במסדי נתונים, אחסון ועומסי עבודה כלליים. שני שרתי GPU, שכל אחד מהם כולל שמונה מאיצים, יכולים להשתלב באותו ארון, אם כי הדבר בא על חשבון המקום הזמין למעבדים המרכזיים.
לפי המפרט שפרסמה AMD, התכנון תומך גם ברוחב פס תקשורתי כולל של עד 102Tbps. הארון מבוסס על תקני Open Compute Project, ברוחב של 21 אינץ' ובגובה של 44 יחידות OpenU, עם אפשרות לקירור אוויר או לקירור נוזלי ישיר.
אחד המרכיבים המעניינים במערכת הוא מנגנון לניתוב בקשות בין מודלי AI. במקום שכל פעולה תישלח אוטומטית למודל הכבד והיקר ביותר, התשתית יכולה להפנות בקשות למודלים מסחריים בענן או למודלים פתוחים המופעלים מקומית, בהתאם לצורך. המשמעות היא פוטנציאל להפחתת עלויות ההסקה ולניצול יעיל יותר של המאיצים.
וכאן מגיע פרט משמעותי נוסף: AMD אינה מתכננת למכור את Helion כארון שרתים מוגמר בעצמה. מדובר בתכנון ייחוס פתוח, שיצרניות שרתים כמו Dell, HPE, Lenovo ו-Supermicro יוכלו להתאים למוצריהן. התצורות הראשונות צפויות להיות זמינות באמצעות השותפות כבר בנובמבר 2026, כשהיקף הפריסה המסחרית יהיה תלוי בקצב האימוץ שלהן.
הגישה הזאת מבדילה את Helion ממערכת Helios של AMD, שמיועדת בעיקר לאימון מודלי AI ולהסקה בהיקפים גדולים. Helios מרכזת מערך מאיצים המחוברים לפעול יחד, בעוד Helion נותנת עדיפות לגמישות ולחלוקת עומסי העבודה. בארגונים גדולים, שתי המערכות עשויות לפעול זו לצד זו.
Verano והמרוץ לצמצום צריכת החשמל
לצד Helion, מנכ"לית AMD ליסה סו חשפה לראשונה מעבד פיזי ממשפחת EPYC Verano, המיועד להגיע לשוק במהלך 2027. בניגוד למעבדי Venice הרגילים, Verano מתוכנן במיוחד לשמש כמעבד מארח למאיצי AI, עם דגש על רוחב פס גבוה, תקשורת מהירה וצריכת חשמל נמוכה יותר ברמת המערכת.
השינוי המרכזי הוא המעבר לזיכרון LPDDR5X, המוכר בעיקר ממחשבים ניידים וממכשירים שבהם יעילות אנרגטית חשובה במיוחד. Verano צפוי להשתמש במודולי SOCAMM2, שמאפשרים לשלב זיכרון LPDDR בצפיפות גבוהה תוך שמירה על האפשרות להחליף מודולים, במקום להלחים את רכיבי הזיכרון ישירות ללוח.
לפי הפרטים שהציגה AMD בעבר, הפלטפורמה מתוכננת לתמוך בעד 24 ערוצי LPDDR5X ובקישוריות xGMI במהירות של עד 112Gbps. החיבור המהיר נועד לצמצם את צוואר הבקבוק בין המעבד המרכזי למאיצים הגרפיים, במיוחד במערכות שבהן ה-CPU נדרש להזין מספר מאיצים בנתונים בו-זמנית.
סוגיית מספר הליבות עדיין דורשת זהירות. AMD הציגה בעבר תכנון של עד 72 ליבות עבור Verano, בעוד פרטים שעלו סביב ההדגמה האחרונה מצביעים על אפשרות לתצורה של 192 ליבות. החברה עדיין לא פרסמה מפרט סופי ומלא שמבהיר את ההבדל בין התצורות, כך שאין סיבה להתייחס למספר הגבוה כנתון סגור.
הבחירה ב-LPDDR5X גם מציבה את Verano מול מעבדי Vera של NVIDIA, שמשלבים זיכרון חסכוני בחשמל כחלק מתשתיות ה-AI שלה. המאבק בין החברות כבר אינו מתנהל רק סביב ביצועי המאיצים עצמם, אלא גם סביב היכולת להפעיל אותם בלי לבזבז חשמל ומשאבים על יתר המערכת.
ההערכה היא שזו בדיוק הסיבה להשקעה של AMD בשתי פלטפורמות שונות. במשך שנים תעשיית ה-AI התמקדה בהגדלת כוח החישוב של המודלים, אבל המעבר לסוכנים אוטונומיים יוצר בעיה אחרת: איך מפעילים מיליוני תהליכים, מחברים אותם לשירותים חיצוניים ומנהלים את עלויות התשתית שלהם בלי שכל פעולה פשוטה תחייב שימוש במאיץ יקר.
ליסה סו מעריכה ששוק מעבדי השרתים יוכל לצמוח בקצב שנתי של כ-50% ולהגיע להיקף של יותר מ-200 מיליארד דולר עד 2030, בעיקר בעקבות הביקוש למערכות AI אוטונומיות. זו תחזית שאפתנית של AMD, ולא נתון שמבטיח שהביקוש אכן יתממש.
המספר 32,768 אולי מושך את תשומת הלב, אבל הסיפור החשוב באמת נמצא במקום אחר. AMD מהמרת על כך שבעתיד הקרוב לא יספיק להחזיק את מודל ה-AI החזק ביותר. יהיה צורך גם בתשתית שמסוגלת לתת לאלפי סוכנים לעבוד במקביל, מבלי שעלות החומרה והחשמל תהפוך את הרעיון לבלתי משתלם.