מנכ"ל OpenAI טוען שזיכרון יקר מתבזבז במחשבים שמריצים AI לעיתים רחוקות, דווקא כשחברות הענן דוחפות את מחירי ה-DRAM למעלה
בזמן שמחירי הזיכרון ממשיכים לעלות, סם אלטמן, מנכ"ל OpenAI, מצא בעיה מעניינת בשוק המחשבים: יותר מדי זיכרון RAM נמצא אצל המשתמשים, במקום לעבוד בחוות שרתים. בראיון שפורסם ב-29 באוקטובר הסביר אלטמן מדוע, בעיניו, התקנת כמויות גדולות של DRAM במחשבים אישיים היא ניצול לא יעיל של משאב שהולך ונעשה יקר יותר. הטיעון שלו הגיוני ברמה הטכנית, אבל מגיע ממי שמוביל את אחת החברות שדוחפות את הביקוש לאותו משאב בדיוק.
אלטמן לא קרא להפסיק למכור זיכרון למחשבי גיימינג או להוציא את מודולי ה-DDR5 מהמחשב שלכם. הדברים נאמרו במסגרת דיון על הרצת מודלי בינה מלאכותית באופן מקומי, והאפשרות שמחשבים אישיים יחליפו חלק מהתשתיות בענן. אלא שההבחנה הזאת לא ממש פותרת את השאלה המרכזית: מי צריך לקבל עדיפות כשאין מספיק שבבי זיכרון לכולם?
למה אלטמן חושב שהמחשב שלכם מבזבז זיכרון
הטענה של אלטמן מתחילה בשינוי שמתרחש בעולם הבינה המלאכותית. מודלים בעלי משקלים פתוחים מאפשרים למשתמשים להוריד את המודל, לטעון אותו לזיכרון המחשב ולהריץ אותו באמצעות המעבד או הכרטיס הגרפי, בלי לשלוח כל בקשה לשרת מרוחק. התהליך הזה נקרא Local Inference, והוא הולך ונעשה מעשי גם במחשבים שאינם תחנות עבודה יקרות.
לדברי אלטמן, הנחת העבודה שלפיה מודלים מקומיים יפחיתו משמעותית את הצורך בחוות שרתים מתעלמת משאלת ניצול החומרה. הוא תיאר מצב שבו חלק מההיצע העולמי המוגבל של DRAM מותקן במחשבים פרטיים ומשמש להרצת AI רק 5% מהזמן. מבחינתו, עדיף לרכז את הזיכרון במרכזי נתונים, שבהם אפשר לחלק את משאבי המחשוב בין משתמשים רבים ולשמור על ניצול גבוה לאורך היום.
זאת טענה שיש מאחוריה היגיון הנדסי. כאשר אלפי משתמשים שולחים בקשות לשירות ענן בזמנים שונים, ספק השירות יכול לשתף תשתיות בין עומסי עבודה ולנצל טוב יותר את החומרה. מחשב אישי שמריץ מודל גדול פעמיים ביום עדיין זקוק למספיק זיכרון כדי להפעיל אותו ברגע העומס, גם אם בשאר הזמן המודל אינו פעיל.
אלא שהנתון של 5% לא הוצג כתוצאה של מדידה מקיפה, אלא כחלק מהדוגמה שהביא אלטמן. חשוב גם להבחין בין תדירות ההרצה של מודל AI לבין ניצול הזיכרון במחשב כולו. אותם 32GB או 64GB משמשים גם משחקים, דפדפנים, תוכנות עריכה, מכונות וירטואליות ויישומים אחרים. העובדה שהמשתמש אינו מריץ מודל שפה בכל רגע לא הופכת את הזיכרון שלו למיותר.
היצרניות כבר התחייבו לשנים של אספקה
האמירות של אלטמן מגיעות בתקופה שבה יצרניות הזיכרון מעדיפות לנתב יותר מכושר הייצור שלהן למוצרים המיועדים לשרתים ולמערכות AI, שבהם ניתן לגבות מחירים גבוהים יותר. הדבר משפיע גם על זמינות הזיכרונות למחשבים האישיים, אפילו כאשר הביקוש הצרכני עצמו אינו חזק במיוחד.
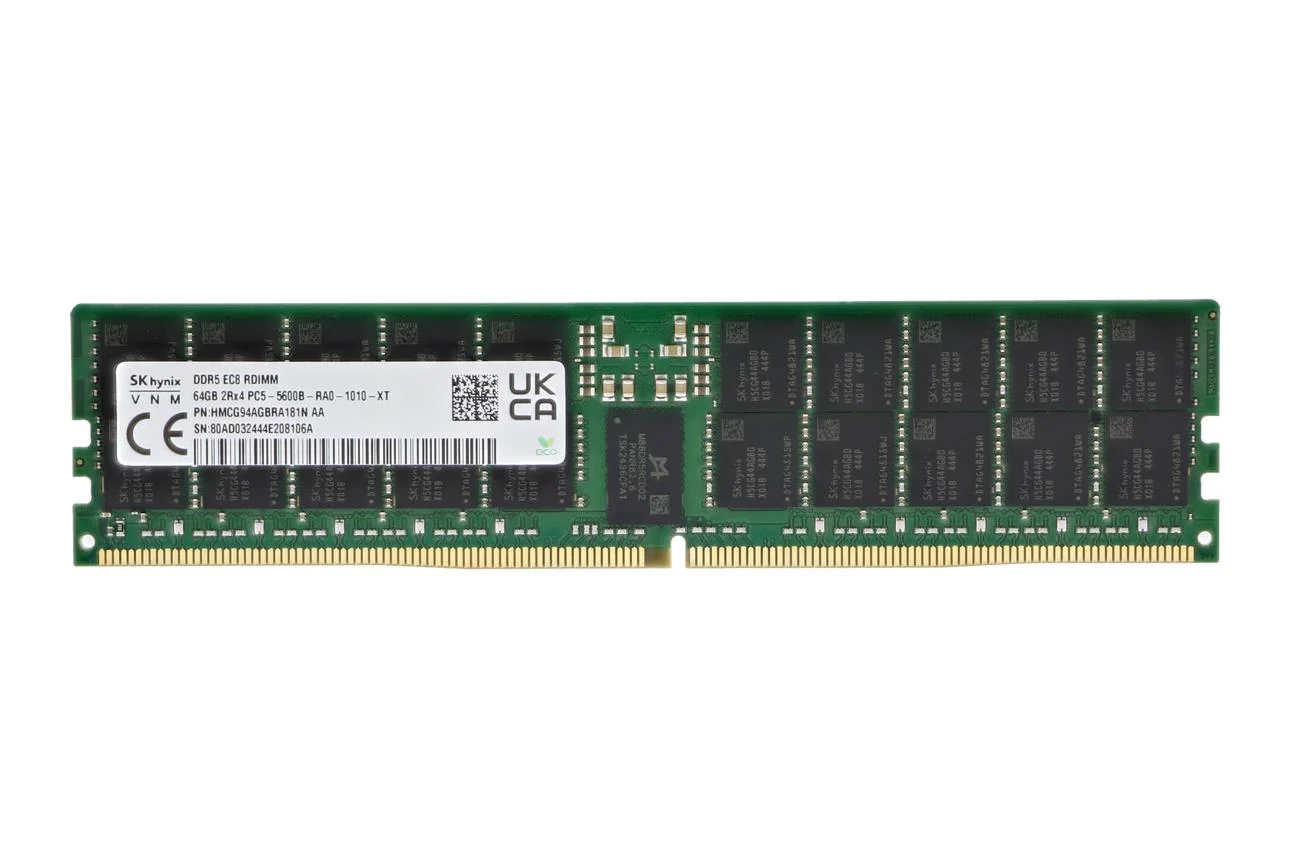
לפי נתוני שוק מספטמבר, מחירי החוזים של זיכרונות DRAM רגילים צפויים לעלות ב-10% עד 15% ברבעון הרביעי של 2026 לעומת הרבעון הקודם. המחסור אינו נובע רק ממכירות של זיכרונות HBM למאיצי AI. גם הביקוש ל-DDR5 בשרתים רגילים עולה, ומקשה על היצרניות להקצות מספיק כושר ייצור למחשבים ולמכשירים ניידים.
צריך לדייק כאן: HBM, זיכרון שרתים מסוג RDIMM ומודולי DDR5 למחשבים ביתיים אינם מוצרים שאפשר להחליף ביניהם באופן ישיר. הם משתמשים בתצורות ובתהליכי ייצור שונים. אבל הם מתחרים על חלק מאותם משאבי תעשייה, והחלטות היצרניות לגבי חלוקת כושר הייצור משפיעות על ההיצע בכל אחד מהשווקים.
הנתונים האחרונים של SK hynix ממחישים עד כמה המצב כבר נקבע מראש. החברה דיווחה ב-28 באוקטובר שחתמה על הסכמי אספקה ארוכי טווח עם 14 לקוחות גדולים, המכסים יותר מ-50% מכושר הייצור המתוכנן שלה בשנים 2027 ו-2028. היא גם מעריכה שהביקוש לזיכרונות ימשיך לעלות על ההיצע עד 2030. זו תחזית של יצרנית, לא ודאות, אבל היא מבהירה מדוע המחשבים האישיים אינם נמצאים כרגע בראש סדר העדיפויות.
OpenAI אינה צופה מהצד במצב הזה. כבר באוקטובר 2025 הודיעה החברה על שיתוף פעולה עם Samsung ו-SK hynix במסגרת פרויקט Stargate, שבמסגרתו מתוכננת הרחבת ייצור שבבי DRAM בקצב יעד של 900 אלף פרוסות סיליקון בחודש. מדובר ביעד להגדלת כושר הייצור, ולא בכמות זיכרון שכבר נרכשה או הובטחה ל-OpenAI, אבל היקף התוכנית ממחיש את התחרות על משאבי הייצור.
עבור הצרכן הישראלי, התוצאה האפשרית פשוטה: התייקרות של שדרוגי RAM, מחשבים ניידים ומחשבי גיימינג, ובהמשך גם מכשירים שמשתמשים בזיכרון מסוג LPDDR. עליית מחירי החוזים אינה מתורגמת אוטומטית לאותה התייקרות בחנויות, משום שהמחיר הסופי תלוי גם במלאים, בשערי מטבע ובמרווחי השיווק, אבל הלחץ מגיע מאותה שרשרת אספקה.
כשהענן יעיל יותר, אבל הבעלות שווה פחות
יש גם אירוניה מסוימת בכך שדווקא OpenAI מספקת טיעון נגד שימוש מקומי נרחב בזיכרון. החברה עצמה השיקה באוגוסט 2025 את משפחת gpt-oss, הכוללת את gpt-oss-20b שניתן להריץ במכשירים עם 16GB זיכרון בלבד, ואת gpt-oss-120b שמיועד לרוץ בתצורה הדורשת כ-80GB. ההשקה הציגה בדיוק את האפשרות שאלטמן מבקש כעת לבחון דרך שאלת יעילות הקצאת המשאבים: הרצת מודלים על חומרה שהמשתמש שולט בה.
וזאת הנקודה שבה הדיון כבר אינו טכני בלבד. עבור OpenAI, שרת שמשרת משתמשים רבים יכול להיות פתרון כלכלי יעיל יותר ממאות מחשבים שכל אחד מהם מחזיק עותק משלו של מודל. אבל עבור המשתמש, היתרונות של הרצה מקומית אינם נמדדים רק במספר הבקשות לשעה.
מודל מקומי יכול לפעול ללא חיבור לאינטרנט, לעבד קבצים רגישים בלי לשלוח אותם לספק חיצוני, ולהמשיך לעבוד גם אם שירות הענן אינו זמין או משנה את המחירים שלו. המשתמש משלם מראש על החומרה, במקום להיות תלוי בתמחור מתמשך לפי מנוי או שימוש. מנגד, ענן יכול להציע מודלים גדולים יותר וחומרה שהמשתמש הפרטי אינו יכול להרשות לעצמו.
הבחירה בין AI מקומי לענן אינה רק שאלה של אחוזי ניצול זיכרון, אלא גם של פרטיות, עלויות ושליטה.
יש כאן גם אינטרס עסקי ברור. המודל המרכזי של OpenAI מבוסס על שירותים מרוחקים, שהכנסותיהם תלויות בשימוש בתשתיות שלה. ככל שיותר פעולות AI מתבצעות על המחשב האישי, חלק מהצורך בשירותים האלה עשוי להצטמצם. זה לא אומר שאלטמן טועה לגבי יתרונות הריכוז בענן, אבל בהחלט מסביר מדוע הפתרון שהוא מציע תואם גם את המודל העסקי של החברה.
הבעיה בטיעון של אלטמן אינה עצם ההעדפה לניצול יעיל של זיכרון, אלא ההנחה שיעילות ברמת התשתית העולמית צריכה להכתיב היכן ראוי שהזיכרון יותקן. בסופו של דבר, מחשב אישי אינו חוות שרתים קטנה שצריכה להצדיק כל גיגה-בייט מול מנהל תשתיות. הוא מוצר שנרכש כדי לשרת את בעליו, גם כשהוא אינו עובד בתפוקה מלאה. והעובדה שחברות ה-AI מסוגלות להפיק יותר הכנסות מכל שבב זיכרון אינה הופכת את השימוש הפרטי בו לפחות לגיטימי.