פריצה לקושחה משחררת ביצועי AI שהוגבלו בכרטיסי RTX 20, 30 ו-40, ללא שינוי בחומרה, אבל השיפור בפועל תלוי במשימה ולא משפיע על משחקים
מתברר שחלק מכרטיסי המסך של NVIDIA הסתובבו במשך שנים עם יכולות חישוב שהחומרה שלהם מסוגלת לספק, אבל החברה בחרה להגביל. עכשיו, קבוצת מפתחים עצמאיים הצליחה לעקוף את ההגבלות האלה ולהציג שיפור של עד פי שניים בביצועים של פעולות AI מסוימות, אפילו בכרטיסי GeForce שהושקו לפני שמונה שנים.
החלק המעניין הוא שלא מדובר בהמהרה, בהחלפת רכיבים או אפילו בהתקנת BIOS לא רשמי. באמצעות ניצול חולשה במנגנון הקושחה של NVIDIA, המפתחים הצליחו לשנות הגדרות פנימיות שמגבילות את קצב ביצוען של פעולות חישוב מסוימות. התוצאה היא שכרטיס RTX 4090, למשל, מסוגל לבצע כעת פעולות Tensor מסוימות בקצב כפול מזה שהתאפשר לו בהגדרות היצרן.
RTX 4090 מגיע ל-331 טרה-פלופס, וגם כרטיסים ישנים מרוויחים
התוצאות הבולטות ביותר מגיעות מכרטיס GeForce RTX 4090, המבוסס על ארכיטקטורת Ada Lovelace. בבדיקת ביצועים של פעולות Tensor מסוג FP16 עם צבירה בדיוק FP32, הכרטיס השיג 165.6 טרה-פלופס לפני הסרת ההגבלה. לאחר הפעלת העקיפה, התוצאה זינקה ל-331.6 טרה-פלופס. תוצאה כמעט זהה נרשמה גם בחישובי BF16, שהשתפרו מ-165.5 ל-330.6 טרה-פלופס.
המספרים האלה משמעותיים במיוחד משום שהם הושגו ללא הגדלת מספר ליבות העיבוד, ללא שינוי בתדרי העבודה וללא העלאת מגבלת ההספק של הכרטיס, שנותרה על 450 ואט. בדיקות נוספות הצליחו לשחזר את הכפלת קצב הפעולות גם במערכת אחרת, עם מנהל התקן רגיל של NVIDIA.
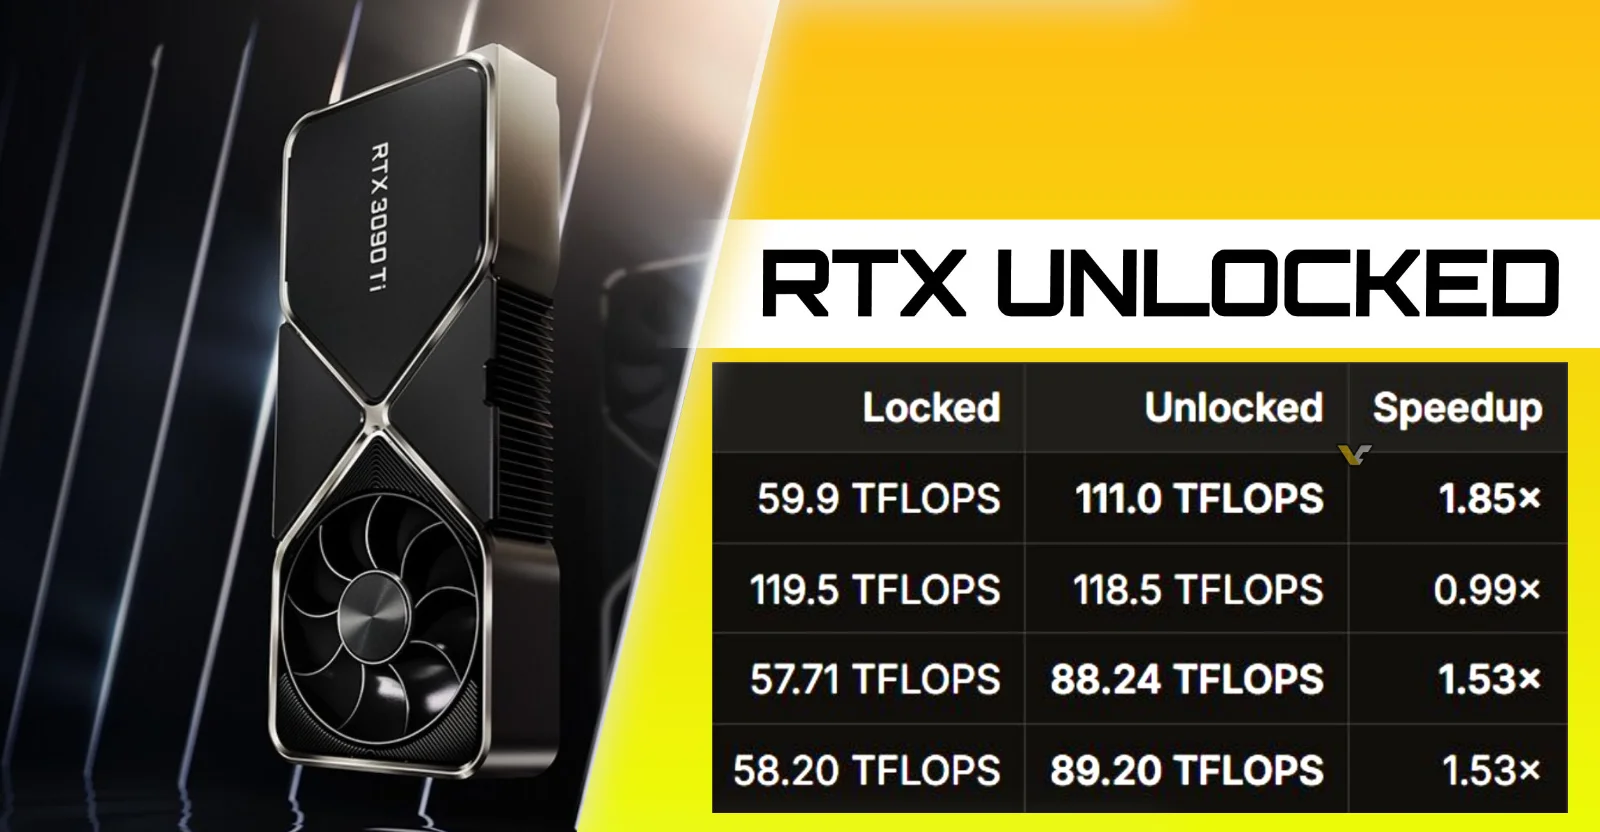
גם בעלי כרטיסי RTX 30 יכולים להרוויח. בפרויקט GPU-Unlock, שמוביל המפתח Zagitta, נמדד בכרטיס RTX 3090 Ti שיפור של כ-80% בביצועי כפל מטריצות מסוג BF16, מ-87.5 ל-157.4 טרה-פלופס. בחישובי TF32 נרשם שיפור של כ-94%, בעוד שחישובי FP16 השתפרו בכ-35%.
הפרויקט כבר הציג הצלחות גם בכרטיסי RTX 3060, RTX 3070, RTX 3080 ו-RTX 3090. בחלק מהמקרים נרשמו שיפורים של 70% עד 80% בחישובי BF16, אם כי התוצאות משתנות בהתאם לדגם, למגבלת ההספק ולתוכנה. לא כל הכרטיסים המבוססים על אותן ארכיטקטורות אומתו בהצלחה.
אפילו GeForce RTX 2080 Ti משנת 2018 הצטרף לחגיגה. בניסוי שנערך בכרטיס המבוסס על ארכיטקטורת Turing, קצב ביצוען של הוראות Tensor מסוימות כמעט הוכפל, וביצועי כפל מטריצות השתפרו בכ-77%. הניסוי הזה מעניין במיוחד משום שהוא מראה שההגבלות אינן תופעה חדשה שהופיעה עם הפופולריות של מודלי השפה.
שני ביטים בקושחה מפרידים בין הביצועים המוגבלים למלאים
כדי להבין מה בדיוק נחשף כאן, צריך להכיר את ההפרדה ש-NVIDIA עושה בין כרטיסי GeForce לצרכנים לבין כרטיסי העבודה המקצועיים שלה. למרות שחלק מהמוצרים מבוססים על אותם שבבים, הם אינם בהכרח מקבלים גישה לאותן יכולות חישוב.
אחת ההגבלות משפיעה על פעולות מתמטיות שבהן הנתונים מיוצגים בדיוק של 16 ביט, אבל התוצאות המצטברות נשמרות בדיוק של 32 ביט. מדובר בשילוב שימושי במיוחד לרשתות נוירונים, שמאפשר לבצע חישובים במהירות תוך שמירה על דיוק גבוה יחסית בתוצאות.
בכרטיסי GeForce מסוימים, קצב ביצוען של ההוראות האלה הוגבל לכמחצית מהיכולת הזמינה בחומרה. בכרטיסים מקצועיים המבוססים על שבבים דומים, ההגבלה הזאת אינה בהכרח קיימת.
המפתחים גילו שאפשר לשנות את המצב באמצעות שני ביטים ברגיסטרים פנימיים, שקובעים את קצב הנפקת הוראות החישוב. אלא שהרגיסטרים האלה מוגנים מפני שינוי רגיל, ולכן לא מספיק להתקין תוכנה שתכתוב אליהם ערך חדש.
הפתרון מנצל חולשת אבטחה ברכיב קושחה הפועל בתוך מעבד האבטחה של ה-GPU. החולשה מאפשרת להריץ קוד ברמת הרשאות גבוהה, לשנות את ההגדרות המוגנות ולאתחל את כרטיס המסך לפני שמנהל ההתקן הרגיל של NVIDIA נטען.
המשמעות היא שלא צריך לצרוב VBIOS חדש או לשנות פיזית את הכרטיס. השינוי מתבצע בכל הפעלה של המערכת, ונעלם לאחר ניתוק הכרטיס מהחשמל. לפחות בחלק מהמימושים, גם אין צורך במנהל התקן שעבר שינוי.
הכלים מפותחים בעיקר עבור Linux, לצד ניסיונות ראשוניים להפעיל את השיטה גם ב-Windows. הם עדיין רחוקים מלהיות פתרון שמיועד למשתמש הממוצע. הפעלה לא נכונה עלולה להשאיר מערכת שאינה עולה, לגרום לתקיעות ואף לסכן חומרה או נתונים. מעבר לכך, הסרת ההגבלה אינה מבטיחה פעולה תקינה בכל דגם ובכל עומס.
מבחני הביצועים מרשימים, אבל מה באמת משתנה בשימוש?
כאן מגיעה ההבחנה החשובה ביותר: הכפלת קצב פעולות Tensor מסוימות אינה שקולה להכפלת ביצועי ה-AI הכוללים של כרטיס המסך.
בבדיקות מעשיות של RTX 4090, השיפור בביצועי כפל מטריצות באמצעות ספריית cuBLAS היה צנוע בהרבה מהתוצאה התיאורטית, ונע בין 12% ל-34% בחישובי FP16, ועד כ-20% בחישובי BF16. בחלק מהכרטיסים האחרים נרשמו שיפורים גבוהים יותר, אך קשה להשוות ביניהם ישירות בגלל הבדלים בתנאי הבדיקה.
אחת הדוגמאות המעניינות מגיעה מכרטיס RTX 3090 שהריץ מודל שפה באמצעות vLLM. בבדיקה השוואתית של אותה מערכת, קצב עיבוד הפרומפט הראשוני (Prefill) השתפר בכ-33%, וזמן ההמתנה לתחילת התשובה התקצר בכ-24%. לעומת זאת, קצב יצירת הטוקנים לאחר תחילת התשובה נותר כמעט ללא שינוי.
ההסבר פשוט: עיבוד ראשוני של פרומפט ארוך דורש כמות גדולה של פעולות חישוב מקבילות, ולכן יכול להרוויח מהגדלת קצב העבודה של ליבות Tensor. יצירת טוקנים בזה אחר זה מוגבלת פעמים רבות דווקא על ידי רוחב הפס של זיכרון הכרטיס. כשהזיכרון הוא צוואר הבקבוק, שחרור יכולות חישוב נוספות לא פותר את הבעיה.
גם יצירת תמונות באמצעות מודלי Diffusion עשויה להרוויח מהשינוי, אבל היקף השיפור תלוי במודל ובאופן שבו הוא משתמש בחומרה. פעולות אחרות, כמו חישובי INT8 מסוימים, כלל לא הראו שיפור.
ומה לגבי משחקים? כאן אין בשורה. השינוי אינו מאיץ את ביצועי הרינדור הגרפי הרגילים, ולכן אין סיבה לצפות לקפיצה בקצב הפריימים. גם העובדה שטכנולוגיות כמו DLSS משתמשות ב-AI אינה אומרת שהן ירוויחו אוטומטית מהסרת ההגבלה. טרם הודגם שיפור כזה.
למעשה, מי שעשויים להרוויח יותר מכל הם משתמשים שמריצים מודלי AI מקומיים, חוקרים ומפתחים שכבר מחזיקים בכרטיסי GeForce מהדורות הקודמים.
מבחינה עסקית, הסיפור מעניין לא פחות מההישג הטכני. נראה שחלק מהפער בין כרטיסי GeForce למוצרים המקצועיים של NVIDIA נובע מהגבלות שנאכפות באמצעות תוכנה וקושחה, ולא רק מהבדלים פיזיים בשבבים. זו דרך מוכרת לבדל מוצרים ולהגן על שוק החומרה המקצועית, אבל במקרה הזה מתברר שהלקוחות כבר שילמו על החומרה שמסוגלת לבצע את העבודה.
יש כאן גם תוצאה אפשרית שפחות תשמח גיימרים. כרטיסי RTX 3090 ו-RTX 4090 כוללים 24GB של זיכרון גרפי, תכונה שהופכת אותם לאטרקטיביים להרצת מודלי AI מקומיים גם כיום. אם עקיפת המגבלות תהפוך לפתרון יציב ונפוץ, הביקוש לכרטיסים האלה בשוק היד השנייה עשוי לגדול עוד יותר.
נכון לעכשיו, לא הודגמה עקיפה מאומתת עבור כרטיסי GeForce RTX 50 המבוססים על Blackwell, ואין הבטחה שהשיטה הנוכחית תעבוד גם בהם. עדיין לא ברור אם NVIDIA תבחר להתייחס לפרויקטים האלה, לחסום אותם באמצעות עדכונים או פשוט להתעלם.
כך או כך, הניסויים כבר הוכיחו נקודה מעניינת: בחלק מכרטיסי GeForce, הגבול בין הביצועים ששילמתם עליהם לבין הביצועים שהחומרה מסוגלת לספק נקבע על ידי הגדרה פנימית שניתן לשנות.